تکنولوژی RAG چیست؟ راهنمای تولید متن متکی بر بازیابی اطلاعات در هوش مصنوعی

مفهوم و ترجمه فارسی RAG در یک نگاه
اصطلاح RAG که مخفف عبارت Retrieval-Augmented Generation است، در زبان فارسی غالباً به صورت «تولید افزوده با بازیابی»، «تولید متن متکی بر بازیابی اطلاعات» یا «تولید پاسخ با بازیابی دانش» ترجمه میشود. در این معماری، مدل زبانی هوش مصنوعی بهجای تکیه صرف بر حافظه و آموزشهای قبلی خود، ابتدا اطلاعات مرتبط و بهروز را از یک دیتابیس یا منبع خارجی بازیابی (Retrieval) کرده، سپس این دادهها را به پرامپت کاربر میافزاید (Augment) و در نهایت پاسخی کاملاً دقیق، مستند و روان تولید (Generate) میکند.
توسعه روزافزون مدلهای زبانی بزرگ (LLM) دنیا را متحول کرده است، اما این مدلها با چالشهایی مانند عدم دسترسی به دادههای بهروز، محدودیت در دادههای سازمانی و پدیدهای به نام توهم هوش مصنوعی (AI Hallucination) مواجه هستند. معماری RAG یا Retrieval-Augmented Generation راهکاری کلیدی برای حل این چالشهاست.
در این مقاله جامع، مفهوم RAG، نحوه کارکرد، مزایا، کاربردها و تفاوت آن با Fine-Tuning را بر اساس جدیدترین مستندات فنی کمپانی IBM بررسی میکنیم.
تکنولوژی RAG (Retrieval-Augmented Generation) چیست؟
تولید افزوده با بازیابی (RAG) یک معماری پیشرفته در هوش مصنوعی است که مدلهای زبانی بزرگ (LLM) را به پایگاههای داده و منابع اطلاعاتی خارجی متصل میکند.
مدلهای مولد پایه (Foundation Models) بر اساس حجم عظیمی از دادههای عمومی اینترنت آموزش دیدهاند. اما این دادهها محدود به زمان آموزش هستند و شامل اطلاعات محرمانه یا اختصاصی سازمانها نمیشوند. معماری RAG به مدل اجازه میدهد هنگام پاسخگویی به سوالات، ابتدا اطلاعات مرتبط را از پایگاه داده خارجی (مانند اسناد سازمانی، مقالات علمی یا دیتابیسهای گراف) بازیابی کرده و سپس پاسخی دقیق، بهروز و مستند تولید کند.
مزایای کلیدی استفاده از RAG در پروژههای هوش مصنوعی
استفاده از معماری RAG به سازمانها و توسعهدهندگان اجازه میدهد بدون صرف هزینههای سنگینِ بازآموزی مدلها (Retraining)، کارایی هوش مصنوعی را به شکل چشمگیری افزایش دهند:
۱. کاهش هزینههای پیادهسازی و توسعه
آموزش مجدد یا Fine-Tuning یک مدل زبانی روی دادههای اختصاصی، نیازمند پردازشهای سنگین GPU و صرف هزینههای بالاست. RAG به شما این امکان را میدهد که همان کیفیت پاسخگویی را بدون تغییر در پارامترهای اصلی مدل و تنها با اتصال به یک پایگاه داده خارجی به دست آورید.
۲. دسترسی به دادههای بهروز و اختصاصی (Real-Time Data)
مدلهای زبانی دارای Knowledge Cutoff (تاریخ انقضای دانش) هستند. RAG با اتصال به منابع زنده، APIs و پایگاههای داده سازمانی، پاسخهایی مبتنی بر آخرین تغییرات اطلاعاتی ارائه میدهد.
۳. کاهش خطر توهم هوش مصنوعی (AI Hallucination)
گاهی مدلهای زبانی الگوهایی نادرست را شناسایی کرده و اطلاعات غلط را با لحنی کاملاً مطمئن ارائه میدهند. RAG پاسخهای مدل را مستقیماً به دادههای واقعی و تاییدشده محدود (Anchor) میکند و احتمال بروز خطا را به حداقل میرساند.
۴. افزایش اعتماد کاربران با ارائه منبع (Citations)
مدلهای مبتنی بر RAG میتوانند در پاسخهای خود، لینک یا رفرنسِ دقیقِ سند استفادهشده را درج کنند. این ویژگی شفافیت سیستم را بالا برده و ارزیابی صحت اطلاعات را برای کاربران راحتتر میکند.
۵. امنیت دادههای سازمانی (Data Security)
در معماری RAG، دادههای حساس سازمانی وارد فرآیند آموزش مدل عمومی نمیشوند؛ بلکه در پایگاه داده امن خود سازمان (مانند Vector Database) باقی میمانند و مدل تنها در زمان پاسخگویی به آنها دسترسی موقت دارد.
RAG چگونه کار میکند؟ (مراحل اجرای معماری RAG)
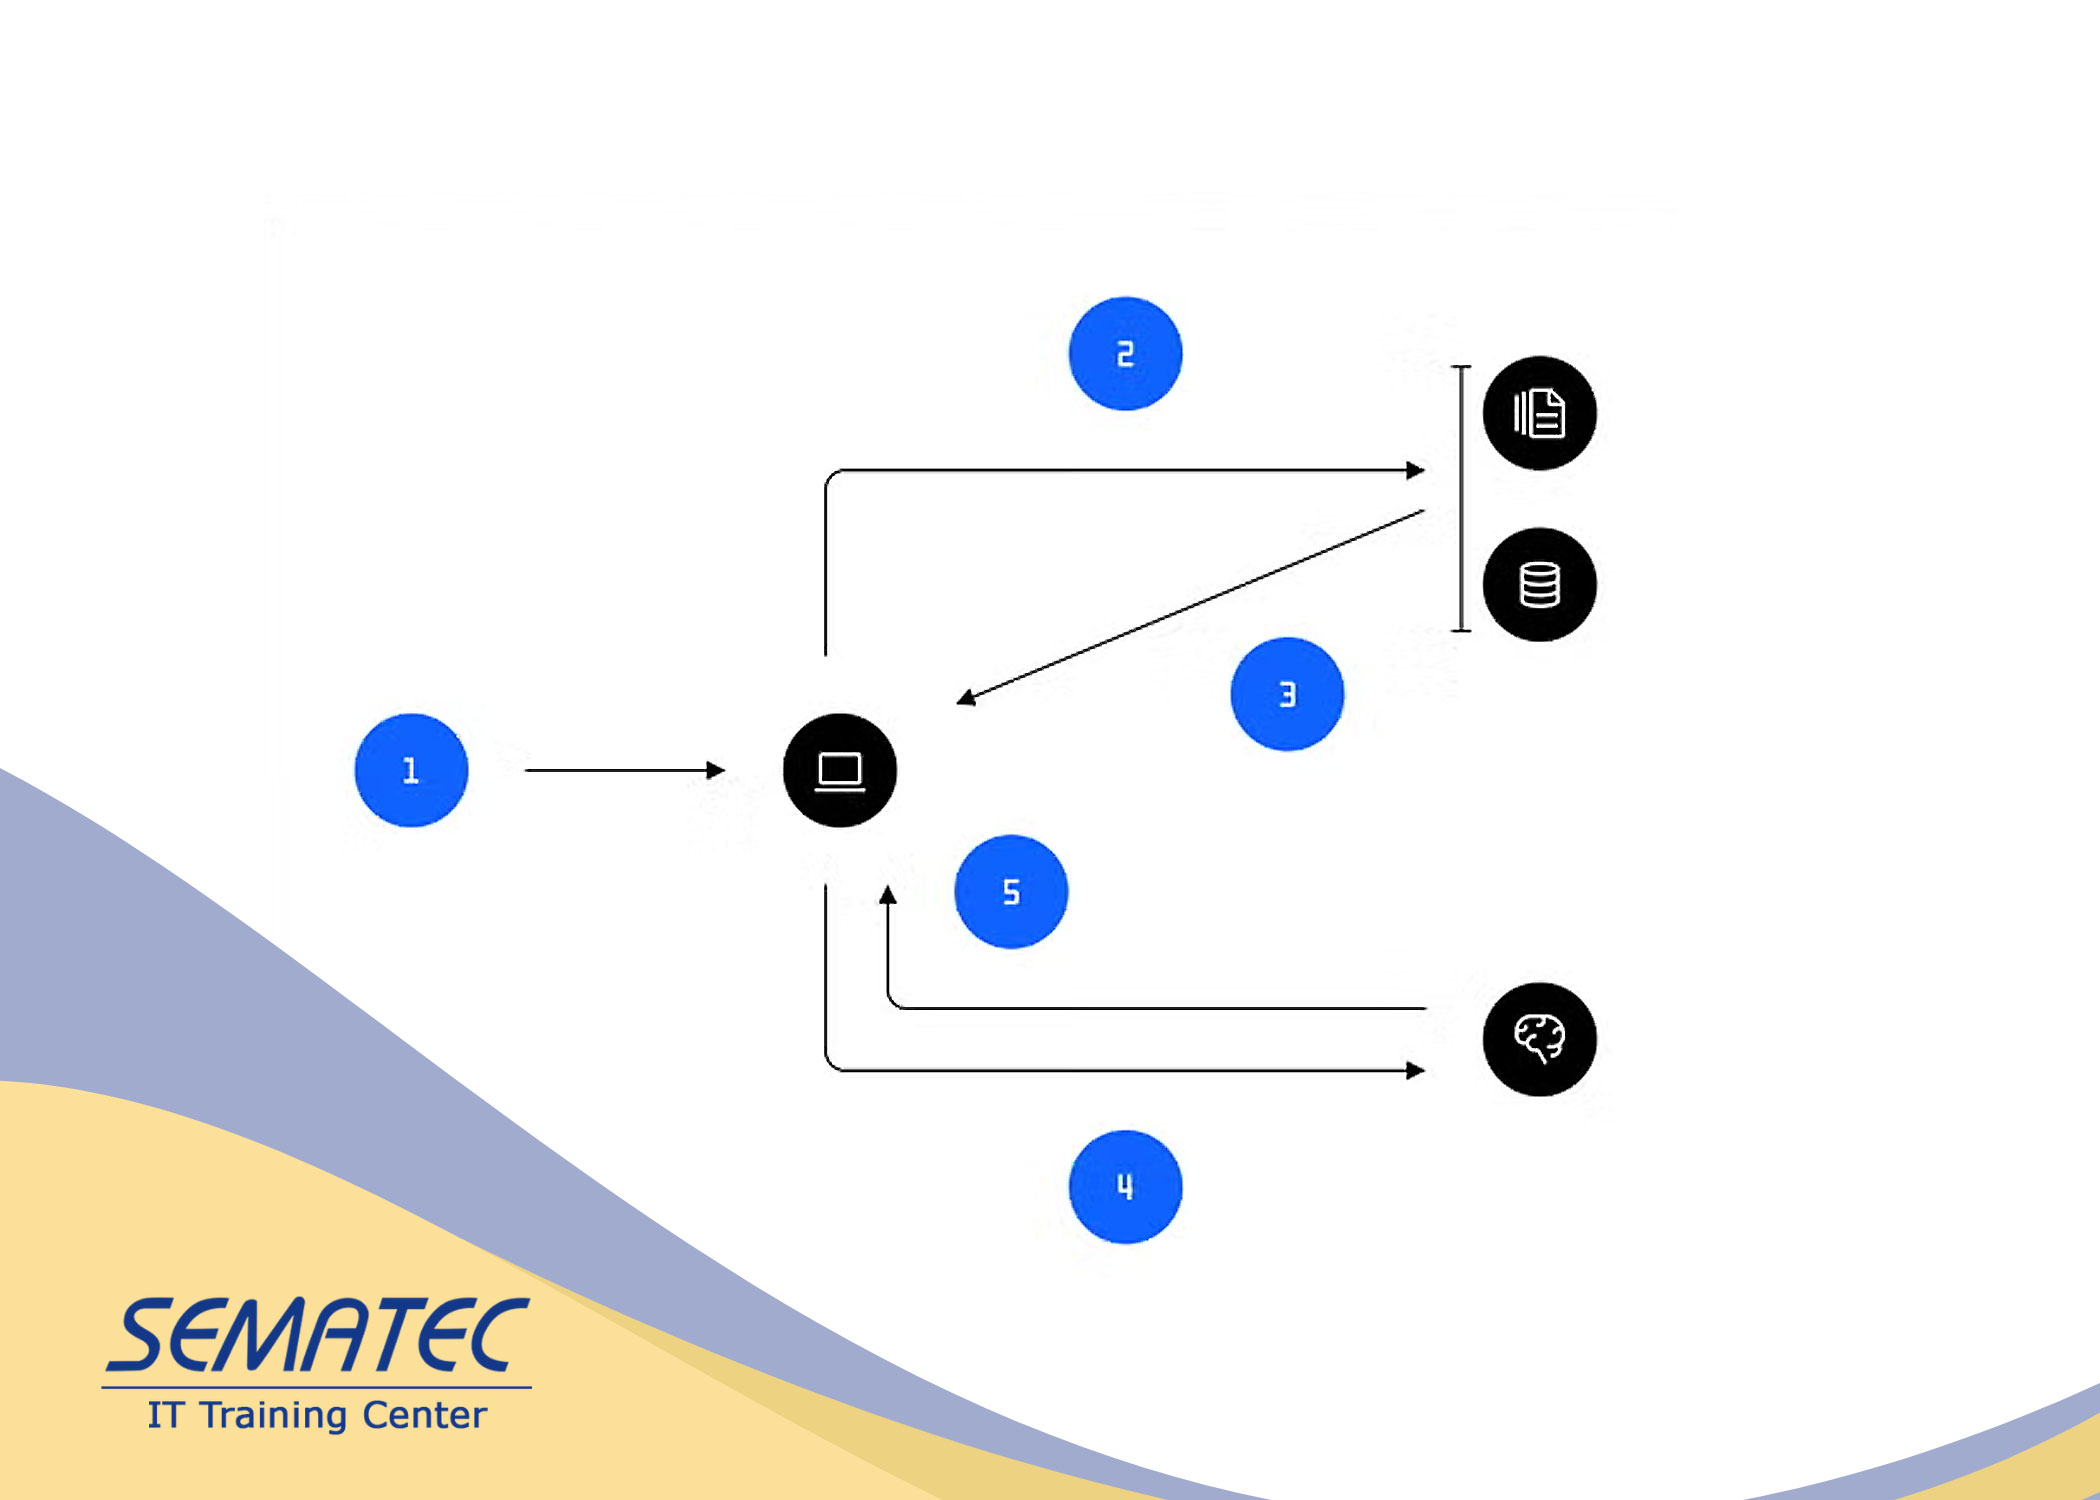
RAG چگونه کار میکند؟ (مراحل اجرای معماری RAG)
فرآیند پاسخگویی در یک سیستم RAG مطابق دیاگرام رسمی IBM از ۵ گام متوالی زیر تشکیل شده است:
- ارسال پرامپت (User Prompt): کاربر پرسش خود را از طریق رابط کاربری ارسال میکند.
- جستجو در پایگاه دانش (Query Knowledge Base): مدل بازیابی اطلاعات، پایگاه داده/دانش را برای یافتن مستندات و دادههای مرتبط جستجو میکند.
- بازخوانی دادهها (Retrieve Data): اطلاعاتِ بازیابیشده از پایگاه دانش به لایه یکپارچهسازی (Integration Layer) منتقل میشوند.
- مهندسی پرامپت غنیشده (Augment Prompt): سیستم RAG پرسش اولیه کاربر را با دادههای بازیابیشده ترکیب کرده و یک پرامپت غنیشده (Augmented Prompt) برای مدل زبانی (LLM) میسازد.
- تولید و ارائه پاسخ (Generate & Return Output): مدل زبانی بزرگ (LLM) بر اساس دادههای واقعی ضمیمهشده، خروجی نهایی را تولید کرده و به کاربر بازمیگرداند.
کاربردهای عملی RAG در صنعت و کسبوکار
معماری RAG امکان ساخت ابزارهای هوشمند متعددی را فراهم کرده است:
- چتباتها و دستیاران پشتیبانی اختصاصی: پاسخگویی هوشمند به مشتریان بر اساس آخرین قوانین، کاتالوگ محصولات و اسناد فنی شرکت.
- تحقیق و تحلیل دادههای مالی و پزشکی: بررسی سریع پروندههای پزشکی یا گزارشهای بازار مالی و استخراج نکات کلیدی.
- موتورهای جستجوی سازمانی (Enterprise Search): دسترسی سریع پرسنل به مستندات داخلی، بخشنامهها و کدهای پروژه.
- تولید محتوای تخصصی: نگارش مقالات و گزارشهای مستند به منابع علمی معتبر.
مقایسه RAG و Fine-Tuning: کدام روش مناسبتر است؟
یکی از سوالات رایج توسعهدهندگان فرانتاند و بکاند، انتخاب بین RAG و Fine-Tuning است:
| ویژگی | RAG (Retrieval-Augmented Generation) | Fine-Tuning |
|---|---|---|
| هدف اصلی | افزودن دانش جدید و دادههای بهروز | تغییر لحن، سبک، یا ساختار پاسخدهی مدل |
| هزینه پیادهسازی | بسیار اقتصادی و سریع | نیازمند سختافزار قوی و هزینه بالا |
| بهروزرسانی دادهها | لحظهای (تنها با آپدیت دیتابیس) | نیازمند آموزش مجدد (Retraining) |
| ارجاع به منبع | دارد (قابلیت Cite کردن اسناد) | ندارد |
| کاهش توهم (Hallucination) | بسیار بالا | متوسط |
نتیجهگیری: اگر هدف شما افزودن اطلاعات جدید و دانش تخصصی به سیستم است، RAG بهترین گزینه است. اما اگر میخواهید مدل نحوه پاسخگویی، لحن یا فرمت خروجی خاصی (مانند تولید کد یا خروجی JSON دقیق) را یاد بگیرد، Fine-Tuning انتخاب مناسبتری خواهد بود. در پروژههای پیشرفته معمولاً از ترکیب هر دو روش استفاده میشود.
مکان RAG در نقشه راه (Roadmap) یادگیری هوش مصنوعی
برای توسعهدهندگان وب و مهندسان نرمافزار، یادگیری RAG در نقطه شروع سطح پیشرفته و ورود به بازار کار واقعی هوش مصنوعی قرار دارد:
- مرحله ۱ (مبانی): برنامهنویسی (پایتون یا جاوا اسکریپت)، آشنایی با REST API و مهندسی پرامپت ساده.
- مرحله ۲ (سطح متوسط): کار با API مدلهای زبانی، آشنایی با Vector Embeddings و پایگاههای داده برداری (مانند Pinecone، Qdrant یا ChromaDB).
- مرحله ۳ (سطح پیشرفته – جایگاه RAG): پیادهسازی سیستمهای RAG با فریمورکهایی مثل LangChain یا LlamaIndex، بهینهسازی استراتژیهای Chunking و اتصال مدل به دیتابیسهای سازمانی.
چرا یادگیری RAG اهمیت دارد؟ امروزه ۹۰٪ شرکتها نیازی به آموزش مدل از صفر ندارند، بلکه میخواهند مدلهای موجود را به دادههای اختصاصی خود متصل کنند؛ این یعنی پیادهسازی RAG یکی از پرتقاضاترین مهارتها برای توسعهدهندگان است.
جمعبندی
تکنولوژی RAG پل ارتباطی میان قدرت پردازش زبان طبیعی در مدلهای LLM و پایگاههای داده واقعی سازمانهاست. تسلط بر مفاهیم RAG و نحوه پیادهسازی آن با پایگاههای داده برداری (Vector Databases) یکی از مهارتهای بسیار ارزشمند و پرتقاضا برای مهندسان نرمافزار و توسعهدهندگان وب در عصر هوش مصنوعی به شمار میرود.
منبع: این مقاله بر اساس مستندات رسمی کمپانی IBM با عنوان What is Retrieval-Augmented Generation (RAG) ترجمه و تدوین شده است.