


واژه نامه و اصطلاحات هوش مصنوعی

هوش مصنوعی در سالهای اخیر با سرعت زیادی پیشرفت کرده و اصطلاحات جدیدی مانند مدل زبانی بزرگ، هوش مصنوعی مولد، ایجنت هوشمند، RAG و MCP وارد دنیای فناوری شدهاند. آشنایی با این مفاهیم به کاربران کمک میکند ابزارهای هوش مصنوعی را بهتر بشناسند و از آنها برای یادگیری، تولید محتوا، برنامهنویسی و خودکارسازی فرایندها استفاده کنند.
در این مقاله، مهمترین اصطلاحات هوش مصنوعی را در قالب یک واژهنامه کاربردی معرفی میکنیم. ابتدا تعریف کوتاه هر اصطلاح را در جدول میخوانید و سپس میتوانید با کلیک روی نام آن، توضیحات کاملتر و مثالهای کاربردی را مشاهده کنید.
فهرست اصطلاحات هوش مصنوعی
برای مشاهده توضیحات هر اصطلاح، روی نام آن در جدول زیر کلیک کنید.
| اصطلاح | توضیح کوتاه |
|---|---|
| AI | هوش مصنوعی؛ فناوری شبیهسازی برخی تواناییهای هوشمندانه انسان. |
| Machine Learning | یادگیری ماشین؛ یادگیری الگوها از دادهها. |
| Deep Learning | یادگیری عمیق با استفاده از شبکههای عصبی چندلایه. |
| Generative AI | هوش مصنوعی مولد؛ تولید متن، تصویر، صدا، ویدئو و کد. |
| LLM | مدل زبانی بزرگ برای پردازش و تولید زبان. |
| Multimodal AI | هوش مصنوعی قادر به کار با چند نوع داده. |
| Training | فرایند آموزش مدل با استفاده از دادهها. |
| Fine-tuning | تنظیم یک مدل آموزشدیده برای کاربردی مشخص. |
| Inference | استفاده از مدل آموزشدیده برای تولید خروجی. |
| Prompt | دستور یا ورودی ارائهشده به مدل. |
| Prompt Engineering | طراحی دستورهای مؤثر برای دریافت خروجی بهتر. |
| System Prompt | دستورالعمل تعیینکننده رفتار و محدودیتهای مدل. |
| Context | اطلاعات زمینهای مورد استفاده مدل برای پاسخگویی. |
| Context Window | محدوده اطلاعاتی که مدل در یک نوبت میتواند پردازش کند. |
| Token | واحد متنی مورد استفاده مدلهای زبانی. |
| Hallucination | تولید اطلاعات نادرست یا ساختگی توسط مدل. |
| Structured Output | تولید خروجی با ساختاری مشخص، مانند JSON. |
| AI Agent | عامل هوشمندی که برای رسیدن به هدف، وظایف را دنبال میکند. |
| Agentic AI | رویکردی برای ساخت سیستمهای هوشمند با توانایی اقدام و برنامهریزی. |
| Skill | مهارت یا مجموعه دستورالعملهای تخصصی برای انجام یک کار. |
| Tool Calling | استفاده مدل از ابزارهای بیرونی برای انجام عملیات. |
| Function Calling | درخواست مدل برای اجرای یک تابع مشخص. |
| Memory | نگهداری اطلاعات لازم برای استفاده در مراحل بعدی. |
| Planning | تقسیم هدف به مراحل قابل اجرا. |
| Orchestration | هماهنگسازی ابزارها، مراحل یا عاملهای هوشمند. |
| Multi-Agent System | سیستمی متشکل از چند عامل هوشمند همکار. |
| Human-in-the-loop | مشارکت انسان در بررسی یا تأیید تصمیمها. |
| API | رابطی برای ارتباط نرمافزارها و سرویسها. |
| Workflow | مجموعهای از مراحل متصل برای انجام یک فرایند. |
| Automation | خودکارسازی وظایف و فرایندها. |
| MCP | پروتکلی برای اتصال مدلهای هوش مصنوعی به ابزارها و منابع داده. |
| RAG | تولید پاسخ با کمک اطلاعات بازیابیشده از منابع. |
| Embedding | تبدیل داده به نمایش برداری عددی. |
| Vector Database | پایگاه داده برای ذخیره و جستوجوی بردارها. |
| Semantic Search | جستوجو بر اساس معنا و مفهوم. |
| Chunking | تقسیم اسناد به قطعات کوچکتر. |
| Knowledge Base | مجموعهای سازمانیافته از اطلاعات و دانش. |
| NLP | پردازش زبان طبیعی. |
| Computer Vision | فناوری تحلیل و درک تصاویر و ویدئوها. |
| Text-to-Image | تولید تصویر از روی توضیحات متنی. |
| Text-to-Speech | تبدیل متن به گفتار. |
| Speech-to-Text | تبدیل گفتار به متن. |
| AI Coding Agent | عامل هوشمند برای انجام وظایف برنامهنویسی. |
| Vibe Coding | توسعه نرمافزار با تکیه زیاد بر توصیف زبان طبیعی و تولید کد توسط AI. |
| Evaluation | ارزیابی کیفیت و عملکرد مدل یا سیستم هوش مصنوعی. |
| Benchmark | معیار یا مجموعه آزمون برای مقایسه عملکرد سیستمها. |
| Prompt Injection | تلاش برای دستکاری رفتار مدل از طریق ورودیهای مخرب. |
| Guardrails | محدودیتها و کنترلهای رفتاری و ایمنی سیستم. |
| Fine-tuning در برابر RAG | دو روش متفاوت برای تخصصیتر کردن کاربرد یک مدل. |
۱. مفاهیم پایه هوش مصنوعی
هوش مصنوعی (Artificial Intelligence یا AI)
هوش مصنوعی به مجموعهای از روشها و فناوریها گفته میشود که به ماشینها امکان میدهند وظایفی مانند تحلیل داده، تشخیص الگو، پردازش زبان، پیشبینی و تصمیمگیری را انجام دهند. هوش مصنوعی لزوماً به معنای داشتن آگاهی یا تفکر مشابه انسان نیست؛ بسیاری از سیستمهای هوشمند برای حل مسئلهای محدود و مشخص طراحی میشوند.
دستیارهای متنی، سیستمهای تشخیص تصویر، ابزارهای ترجمه و عاملهای هوشمند نمونههایی از کاربردهای هوش مصنوعی هستند. در واقع، AI یک مفهوم گسترده است و یادگیری ماشین، یادگیری عمیق و هوش مصنوعی مولد از حوزههای مرتبط با آن به شمار میروند.
یادگیری ماشین (Machine Learning یا ML)
یادگیری ماشین شاخهای از هوش مصنوعی است که در آن سیستم با استفاده از دادهها، الگوها و روابط را یاد میگیرد و بر اساس آنها پیشبینی یا تصمیمگیری میکند. بهجای اینکه برای تمام حالتها قوانین جداگانهای نوشته شود، الگوریتم با دادههای آموزشی تنظیم میشود تا بتواند روی دادههای جدید نیز عملکرد مناسبی داشته باشد.
برای مثال، یک سیستم یادگیری ماشین میتواند با بررسی اطلاعات خرید مشتریان، احتمال خرید مجدد را پیشبینی کند یا پیامهای ناخواسته را از ایمیلهای عادی تشخیص دهد. کیفیت دادههای آموزشی، انتخاب الگوریتم و روش ارزیابی بر عملکرد چنین سیستمهایی تأثیر زیادی دارند.
یادگیری عمیق (Deep Learning یا DL)
یادگیری عمیق یکی از زیرشاخههای یادگیری ماشین است که از شبکههای عصبی با لایههای متعدد برای یادگیری الگوهای پیچیده استفاده میکند. این روش در پردازش زبان، تشخیص تصویر، تولید صدا و بسیاری از کاربردهای پیشرفته هوش مصنوعی نقش مهمی دارد.
مدلهای زبانی بزرگ و بسیاری از مدلهای تولید تصویر با روشهای یادگیری عمیق ساخته میشوند. آموزش این مدلها معمولاً به داده، توان پردازشی و منابع محاسباتی قابلتوجهی نیاز دارد؛ هرچند هزینه اجرای مدل پس از آموزش به اندازه، معماری و سختافزار مورد استفاده بستگی دارد.
هوش مصنوعی مولد (Generative AI)
هوش مصنوعی مولد به سیستمهایی گفته میشود که میتوانند محتوای جدیدی مانند متن، تصویر، موسیقی، صدا، ویدئو یا کد تولید کنند. این سیستمها با یادگیری الگوهای موجود در دادههای آموزشی، خروجیهایی میسازند که با درخواست کاربر یا شرایط ورودی هماهنگ هستند.
تولید مقاله، طراحی تصویر تبلیغاتی، ساخت نمونه اولیه رابط کاربری و پیشنهاد کد از کاربردهای آن هستند. با وجود توانایی بالای این ابزارها، خروجی تولیدشده ممکن است اشتباه، ناقص یا نامناسب باشد؛ بنابراین بررسی انسانی و کنترل کیفیت همچنان اهمیت دارد.
مدل زبانی بزرگ (Large Language Model یا LLM)
مدل زبانی بزرگ نوعی مدل هوش مصنوعی است که با حجم زیادی از دادههای متنی آموزش میبیند تا بتواند زبان را پردازش و متن تولید کند. این مدلها میتوانند در پاسخگویی به سؤالها، خلاصهسازی، ترجمه، تحلیل متن، تولید محتوا و کمک به برنامهنویسی استفاده شوند.
مدل زبانی بزرگ معمولاً پاسخ را بر اساس الگوهای آموختهشده و زمینه در دسترس تولید میکند. به همین دلیل، نباید هر پاسخ آن را حقیقت قطعی دانست. اتصال مدل به منابع معتبر، استفاده از RAG و ارزیابی خروجیها میتواند در برخی کاربردها به بهبود قابلیت اتکا کمک کند.
هوش مصنوعی چندوجهی (Multimodal AI)
هوش مصنوعی چندوجهی به سیستمهایی گفته میشود که میتوانند با بیش از یک نوع داده، مانند متن، تصویر، صدا یا ویدئو، کار کنند. برای مثال، کاربر میتواند تصویری را ارسال کند و درباره محتوای آن سؤال بپرسد یا از سیستم بخواهد یک فایل صوتی را تحلیل و خلاصه کند.
قابلیتهای دقیق مدلهای چندوجهی یکسان نیستند. بعضی مدلها تنها چند نوع ورودی را پشتیبانی میکنند و برخی دیگر قابلیت تولید خروجی در چند قالب را نیز دارند. هنگام انتخاب ابزار باید نوع داده، محدودیت فایلها و قابلیتهای واقعی مدل بررسی شود.
آموزش مدل (Training)
آموزش مدل فرایندی است که طی آن پارامترهای مدل با استفاده از دادهها و الگوریتمهای آموزشی تنظیم میشوند. هدف این فرایند، یادگیری الگوهایی است که به مدل اجازه میدهند وظایف مورد نظر را انجام دهد. نوع داده، روش آموزش و معماری مدل بر نتیجه نهایی تأثیر میگذارند.
آموزش یک مدل بزرگ از ابتدا میتواند بسیار پرهزینه باشد. به همین دلیل، بسیاری از توسعهدهندگان بهجای ساخت مدل از صفر، از مدلهای ازپیشآموزشدیده استفاده میکنند و در صورت نیاز آنها را تنظیم یا به منابع اطلاعاتی متصل میکنند.
تنظیم دقیق مدل (Fine-tuning)
Fine-tuning به فرایند آموزش تکمیلی یک مدل ازپیشآموزشدیده گفته میشود. در این روش، مدل با مجموعه دادهای مرتبط با یک وظیفه یا حوزه خاص دوباره آموزش میبیند تا رفتار یا عملکرد آن برای کاربرد مورد نظر مناسبتر شود.
برای مثال، یک سازمان ممکن است برای طبقهبندی پیامهای پشتیبانی از مدل تنظیمشده استفاده کند. تنظیم دقیق با نوشتن Prompt یا اتصال مدل به اسناد متفاوت است؛ این روش پارامترهای مدل را تغییر میدهد و به داده مناسب، ارزیابی و منابع فنی نیاز دارد.
استنتاج (Inference)
Inference به مرحله استفاده از مدل آموزشدیده برای پردازش ورودی و تولید خروجی گفته میشود. زمانی که یک سؤال را در دستیار هوش مصنوعی وارد میکنید و مدل به آن پاسخ میدهد، فرایند استنتاج در حال انجام است.
سرعت استنتاج و هزینه آن به عواملی مانند اندازه مدل، طول ورودی و خروجی، سختافزار و شیوه سرویسدهی بستگی دارند. در توسعه نرمافزار، بهینهسازی استنتاج میتواند هزینه استفاده از API و زمان پاسخگویی برنامه را کاهش دهد.
۲. اصطلاحات پرکاربرد در تعامل با هوش مصنوعی
پرامپت (Prompt)
پرامپت ورودیای است که کاربر یا یک سیستم به مدل هوش مصنوعی ارائه میکند. این ورودی میتواند یک سؤال ساده، دستور چندمرحلهای، متن مرجع، تصویر یا ترکیبی از اطلاعات باشد. مدل با توجه به پرامپت و زمینه در دسترس، خروجی تولید میکند.
برای مثال، بهجای نوشتن «درباره سئو بنویس»، میتوان درخواست کرد: «یک راهنمای مقدماتی درباره سئوی تکنیکال برای مدیران سایت بنویس و برای هر بخش یک مثال عملی ارائه کن». مشخصکردن هدف، مخاطب، قالب و محدودیتها معمولاً به دریافت خروجی مناسبتر کمک میکند.
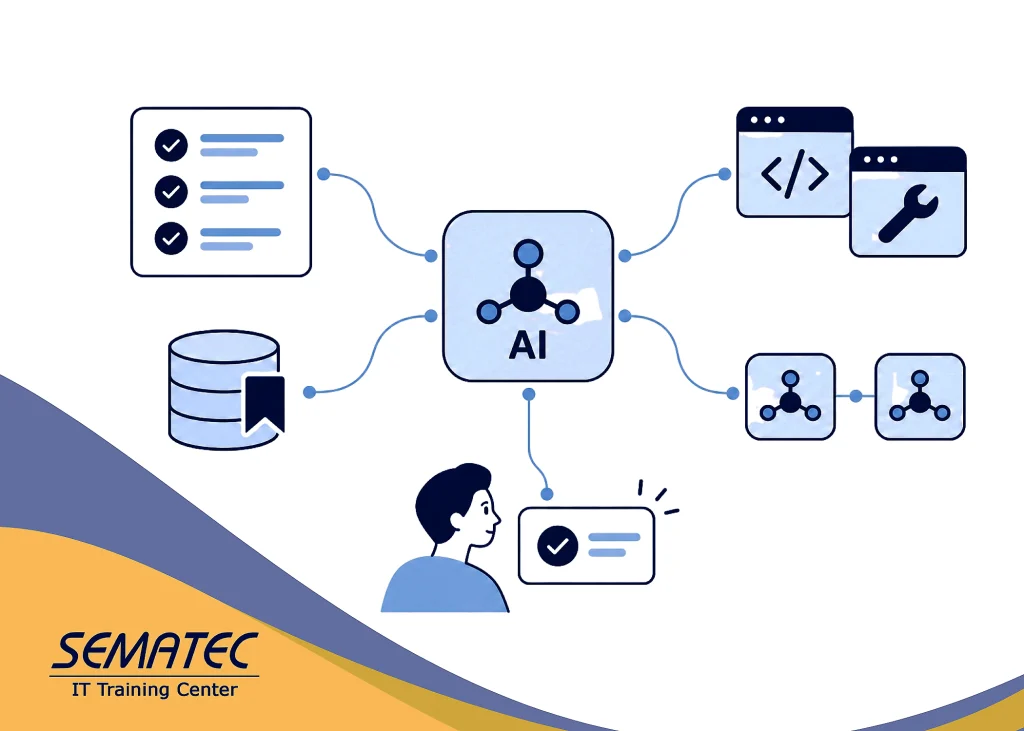
اصطلاحات پرکاربرد در تعامل با هوش مصنوعی
مهندسی پرامپت (Prompt Engineering)
مهندسی پرامپت به طراحی و بهینهسازی دستورها و اطلاعات ورودی گفته میشود تا مدل بتواند وظیفه مورد نظر را بهتر انجام دهد. در این روش، هدف، زمینه، قالب خروجی، محدودیتها و نمونههای مورد نیاز به شکل روشنتری تعریف میشوند.
برای مثال، هنگام درخواست تولید محتوای وبلاگ میتوان ساختار تیترها، لحن نگارش، مخاطب، کلمه کلیدی و منابع مجاز را مشخص کرد. مهندسی پرامپت تضمین نمیکند که پاسخ همیشه درست باشد؛ خروجی باید متناسب با اهمیت وظیفه بررسی و ارزیابی شود.
پرامپت سیستمی (System Prompt)
پرامپت سیستمی مجموعهای از دستورالعملهاست که رفتار مورد انتظار مدل را در یک برنامه یا محیط مشخص میکند. این دستورها ممکن است نقش مدل، سبک پاسخگویی، محدودیتها، قواعد استفاده از ابزارها و نحوه برخورد با درخواستهای مختلف را تعیین کنند.
برای مثال، در یک دستیار آموزشی میتوان تعیین کرد که پاسخها متناسب با سطح مبتدی باشند و مفاهیم با مثال توضیح داده شوند. پرامپت سیستمی بهتنهایی جایگزین کنترل دسترسی، اعتبارسنجی دادهها و سازوکارهای امنیتی نیست و نباید تنها لایه دفاعی برنامه باشد.
زمینه (Context)
Context به اطلاعاتی گفته میشود که مدل برای درک درخواست و تولید پاسخ در اختیار دارد. این اطلاعات ممکن است شامل پیامهای قبلی گفتگو، دستورالعملها، اسناد بازیابیشده، دادههای ساختاریافته یا نتایج اجرای ابزارها باشد.
برای نمونه، اگر از دستیار بخواهید کد قبلی پروژه را اصلاح کند، وجود کد، خطا و توضیحات مربوط به پروژه در زمینه گفتگو به پاسخ دقیقتر کمک میکند. اگر اطلاعات لازم در دسترس مدل نباشد، ممکن است پاسخ ناقص یا نادرست تولید شود.
پنجره زمینه (Context Window)
پنجره زمینه به محدوده اطلاعاتی گفته میشود که مدل در یک نوبت پردازش میکند. این محدوده معمولاً بر اساس توکن سنجیده میشود و میتواند ورودی کاربر، دستورالعملها، پیامهای قبلی و بخشهایی از اطلاعات بازیابیشده را در بر بگیرد.
پنجره زمینه بزرگتر به این معنی نیست که مدل همه جزئیات را بدون خطا به خاطر میسپارد یا همیشه از تمام اطلاعات استفاده میکند. در برنامههای کاربردی، انتخاب اطلاعات مرتبط، خلاصهسازی و بازیابی هدفمند میتواند از ارسال حجم زیادی از دادههای غیرضروری مؤثرتر باشد.
توکن (Token)
توکن واحدی است که مدل زبانی برای پردازش متن از آن استفاده میکند. یک توکن ممکن است بخشی از یک کلمه، یک کلمه کامل، نشانه نگارشی یا بخشی از متن باشد. تقسیم متن به توکنها به زبان و روش توکنسازی مدل بستگی دارد.
تعداد توکنها در بسیاری از سرویسها بر هزینه، محدودیت ورودی و خروجی و ظرفیت زمینه تأثیر میگذارد. به همین دلیل، هنگام توسعه برنامههایی که از API مدلهای زبانی استفاده میکنند، آشنایی با مفهوم توکن و مدیریت طول درخواستها اهمیت دارد.
توهم هوش مصنوعی (Hallucination)
Hallucination زمانی رخ میدهد که مدل پاسخی تولید میکند که نادرست، ساختگی یا فاقد پشتوانه کافی است؛ حتی اگر پاسخ با اطمینان بیان شده باشد. برای مثال، مدل ممکن است منبعی را معرفی کند که وجود ندارد یا درباره قابلیت یک کتابخانه نرمافزاری اطلاعات اشتباه بدهد.
برای کاهش این مشکل میتوان از منابع معتبر، بازیابی اطلاعات، ابزارهای راستیآزمایی، تست و بررسی انسانی استفاده کرد. با این حال، هیچکدام از این روشها تضمین نمیکنند که تمام خطاها حذف شوند؛ بهویژه در تصمیمهای حساس، تأیید اطلاعات اهمیت زیادی دارد.
خروجی ساختاریافته (Structured Output)
خروجی ساختاریافته به پاسخی گفته میشود که از قالبی مشخص پیروی میکند؛ برای مثال، یک شیء JSON با فیلدهای تعریفشده یا خروجی مطابق یک Schema. این قابلیت برای استفاده از مدل در برنامههای نرمافزاری مفید است، زیرا دادهها را میتوان راحتتر پردازش کرد.
برای مثال، یک مدل میتواند اطلاعات یک درخواست پشتیبانی را به فیلدهایی مانند عنوان، اولویت و دستهبندی تبدیل کند. استفاده از قالب ساختاریافته خطاهای قالببندی را کاهش میدهد، اما همچنان باید نوع دادهها، مقادیر مجاز و منطق کسبوکار در برنامه اعتبارسنجی شوند.
۳. اصطلاحات مربوط به Agent و ابزارهای هوشمند
ایجنت هوش مصنوعی (AI Agent)
ایجنت هوش مصنوعی سیستمی است که برای دنبالکردن یک هدف، از مدل هوش مصنوعی و در صورت نیاز از ابزارها، حافظه و سازوکارهای برنامهریزی استفاده میکند. برخلاف یک پاسخگوی ساده که ممکن است تنها به یک سؤال پاسخ دهد، ایجنت میتواند یک وظیفه را به چند مرحله تقسیم کند، اقدام انجام دهد و نتیجه را بررسی کند.
برای مثال، یک ایجنت برنامهنویسی ممکن است ساختار پروژه را بررسی کند، فایلهای لازم را تغییر دهد، تستها را اجرا کند و بر اساس خطاها اصلاحاتی انجام دهد. میزان استقلال ایجنت به طراحی سیستم و دسترسیهای آن بستگی دارد؛ هر اقدامی که روی فایلها، حسابها یا سرویسهای واقعی اثر میگذارد، باید با مجوز و کنترل مناسب انجام شود.
هوش مصنوعی ایجنتی (Agentic AI)
Agentic AI اصطلاحی برای رویکردها و سیستمهایی است که توانایی دنبالکردن هدف، برنامهریزی، انتخاب اقدام و سازگارشدن با نتایج را دارند. این مفهوم بیشتر بر رفتار هدفمحور و میزان استقلال سیستم تأکید میکند و ممکن است شامل یک ایجنت یا مجموعهای از عاملهای هماهنگ باشد.
برای مثال، در یک فرایند تحلیل داده، سیستم میتواند اطلاعات را دریافت کند، تحلیل مناسب را انتخاب کند، خروجی را ارزیابی کند و در صورت لزوم مراحل بعدی را پیشنهاد دهد. Agentic AI لزوماً به معنای استقلال کامل نیست و بسیاری از کاربردهای واقعی به تأیید انسانی و محدودیتهای اجرایی نیاز دارند.
اسکیل یا مهارت (Skill)
Skill در ابزارهای هوش مصنوعی معمولاً به یک قابلیت تخصصی یا مجموعهای از دستورالعملها و منابع گفته میشود که به سیستم کمک میکند نوع مشخصی از کار را با روش تعریفشده انجام دهد. برای مثال، یک Skill میتواند قواعد بررسی کد، شیوه نگارش مقاله یا مراحل تحلیل یک فایل داده را توضیح دهد.
تعریف دقیق Skill به پلتفرم مورد استفاده بستگی دارد. در برخی ابزارهای کدنویسی، Skill بهصورت فایلها و پوشههای حاوی دستورالعمل و منابع ارائه میشود؛ در محیطهای دیگر، ممکن است به قابلیت یا ماژول تخصصی اشاره داشته باشد. Skill بهخودیخود لزوماً یک ایجنت مستقل یا ابزار اجرایی نیست.
فراخوانی ابزار (Tool Calling)
Tool Calling سازوکاری است که به مدل اجازه میدهد برای انجام یک عملیات از ابزار تعریفشدهای درخواست استفاده کند. این ابزار ممکن است برای جستوجوی اطلاعات، خواندن فایل، دریافت داده از API یا اجرای عملیات دیگری طراحی شده باشد.
برای مثال، یک دستیار ممکن است برای پاسخدادن به سؤال درباره وضعیت سفارش، درخواست فراخوانی ابزار دریافت اطلاعات سفارش را صادر کند. معمولاً برنامه میزبان درخواست را اجرا میکند و نتیجه را به مدل برمیگرداند. ابزارها باید محدود و کنترلشده باشند تا مدل نتواند بدون مجوز به اطلاعات یا عملیات حساس دسترسی پیدا کند.
فراخوانی تابع (Function Calling)
Function Calling به سازوکاری گفته میشود که در آن مدل میتواند درخواست اجرای یک تابع مشخص را همراه با آرگومانهای لازم تولید کند. این قابلیت در برنامههای مبتنی بر API به مدل امکان میدهد با منطق نرمافزار یا سرویسهای بیرونی تعامل داشته باشد.
برای نمونه، میتوان تابعی تعریف کرد که قیمت یک محصول را از پایگاه داده دریافت کند. مدل ممکن است درخواست اجرای آن را با شناسه محصول ارائه دهد، اما اجرای واقعی تابع بر عهده برنامه است. Function Calling و Tool Calling در بسیاری از پلتفرمها مفاهیم نزدیک و گاهی همپوشان هستند، هرچند نامگذاری و جزئیات فنی آنها متفاوت است.
حافظه (Memory)
Memory در سیستمهای هوش مصنوعی به سازوکار نگهداری و بازیابی اطلاعات مورد نیاز برای مراحل بعدی گفته میشود. این اطلاعات میتوانند شامل خلاصه گفتگو، ترجیحات کاربر، نتایج اقدامات قبلی یا دادههای مرتبط با یک وظیفه باشند. حافظه در همه ابزارها به یک شکل پیادهسازی نمیشود.
در یک ایجنت، حافظه میتواند کمک کند سیستم پس از اجرای چند مرحله، اطلاعات مهم را از دست ندهد. با این حال، حافظه با پنجره زمینه یکسان نیست؛ پنجره زمینه محدوده اطلاعات قابل پردازش در یک نوبت است، در حالی که حافظه ممکن است اطلاعات را بیرون از همان نوبت نگهداری کند و در زمان نیاز دوباره در اختیار مدل قرار دهد.
برنامهریزی (Planning)
Planning به فرایند مشخصکردن مراحل لازم برای رسیدن به یک هدف گفته میشود. در سیستمهای ایجنتی، برنامهریزی میتواند شامل شناسایی پیشنیازها، تعیین ترتیب اقدامات و انتخاب ابزارهای مناسب باشد.
برای مثال، اگر هدف ساخت یک صفحه ثبتنام باشد، سیستم ممکن است ابتدا نیازمندیها را بررسی کند، سپس فرم و اعتبارسنجی را پیادهسازی کند و در پایان تست بنویسد. برنامهریزی بهتنهایی تضمین نمیکند که تمام مراحل درست اجرا شوند؛ نتایج باید در طول کار بررسی شوند و برنامه در صورت نیاز تغییر کند.
هماهنگسازی (Orchestration)
Orchestration به مدیریت و هماهنگکردن مراحل، ابزارها، سرویسها یا ایجنتهای مختلف برای اجرای یک فرایند گفته میشود. این مفهوم تعیین میکند که چه کاری، در چه زمانی و با چه وابستگیهایی اجرا شود.
برای مثال، در یک سیستم تولید محتوا ممکن است مرحله جمعآوری منابع پیش از نگارش انجام شود، سپس خروجی بررسی شود و در نهایت برای تأیید به ویراستار برسد. Orchestration میتواند با کد، ابزارهای گردش کار یا چارچوبهای تخصصی ایجنت پیادهسازی شود.
سیستم چندایجنتی (Multi-Agent System)
سیستم چندایجنتی از چند عامل هوشمند تشکیل میشود که ممکن است وظایف متفاوتی داشته باشند و برای رسیدن به یک هدف با یکدیگر همکاری کنند. برای مثال، یک ایجنت مسئول تحقیق، دیگری مسئول نگارش و عامل سوم مسئول بررسی کیفیت خروجی باشد.
این معماری میتواند برای وظایف پیچیده مفید باشد، اما همیشه از یک ایجنت ساده بهتر نیست. هماهنگی بیشتر، هزینه اجرا، تکرار کار و دشواری ارزیابی از چالشهای آن هستند؛ بنابراین استفاده از چند ایجنت باید بر اساس نیاز واقعی پروژه انجام شود.
مشارکت انسان در چرخه تصمیمگیری (Human-in-the-loop)
Human-in-the-loop به رویکردی گفته میشود که در آن انسان در بخشی از فرایند هوش مصنوعی دخالت دارد؛ برای مثال، دادهها را بررسی میکند، خروجی را تأیید میکند یا درباره یک تصمیم مهم نظر میدهد.
در کاربردهایی مانند انتشار محتوا، تغییر کدهای حساس یا انجام عملیات مالی، میتوان سیستم را طوری طراحی کرد که ابتدا پیشنهاد را آماده کند و پیش از اجرای نهایی، تأیید فرد مسئول را بخواهد. این روش امکان استفاده از اتوماسیون را فراهم میکند و در عین حال کنترل انسانی را حفظ میکند.
۴. اصطلاحات اتصال ابزارها و خودکارسازی
رابط برنامهنویسی کاربردی (API)
API مجموعهای از قواعد و روشهاست که به نرمافزارها اجازه میدهد با یکدیگر ارتباط برقرار کنند. برای مثال، یک برنامه میتواند از طریق API به سرویس هوش مصنوعی درخواست بفرستد و پاسخ را دریافت کند.
API در ساخت دستیارها و ایجنتها اهمیت زیادی دارد؛ زیرا امکان اتصال مدل به اطلاعات یا قابلیتهای بیرونی را فراهم میکند. در استفاده عملی باید به احراز هویت، محدودیت درخواست، مدیریت خطا، هزینه و حفاظت از کلیدهای دسترسی توجه شود.
گردش کار (Workflow)
Workflow مجموعهای از مراحل تعریفشده است که برای انجام یک فرایند به ترتیب مشخص اجرا میشوند. هر مرحله ممکن است ورودی دریافت کند، داده را پردازش کند یا نتیجه را به مرحله بعد تحویل دهد.
برای مثال، گردش کار انتشار مقاله میتواند شامل دریافت مقاله، تولید خلاصه، بررسی متن و آمادهسازی پیام شبکه اجتماعی باشد. گردش کارها میتوانند کاملاً ثابت باشند یا در بعضی مراحل از مدل هوش مصنوعی برای تحلیل و انتخاب مسیر استفاده کنند.
خودکارسازی (Automation)
Automation به اجرای خودکار وظایف یا فرایندها با حداقل دخالت دستی گفته میشود. این خودکارسازی میتواند بر اساس قوانین مشخص انجام شود یا با استفاده از مدلهای هوش مصنوعی، بخشهایی از تصمیمگیری را نیز پوشش دهد.
برای نمونه، میتوان تنظیم کرد که پس از انتشار یک مقاله، خلاصه آن تولید و برای تأیید آماده شود. پلتفرمهایی مانند n8n امکان اتصال سرویسها و ساخت گردش کار را فراهم میکنند. اتوماسیون معمولی الزاماً ایجنت نیست، اما میتواند یک ایجنت را در بخشی از فرایند به کار بگیرد.
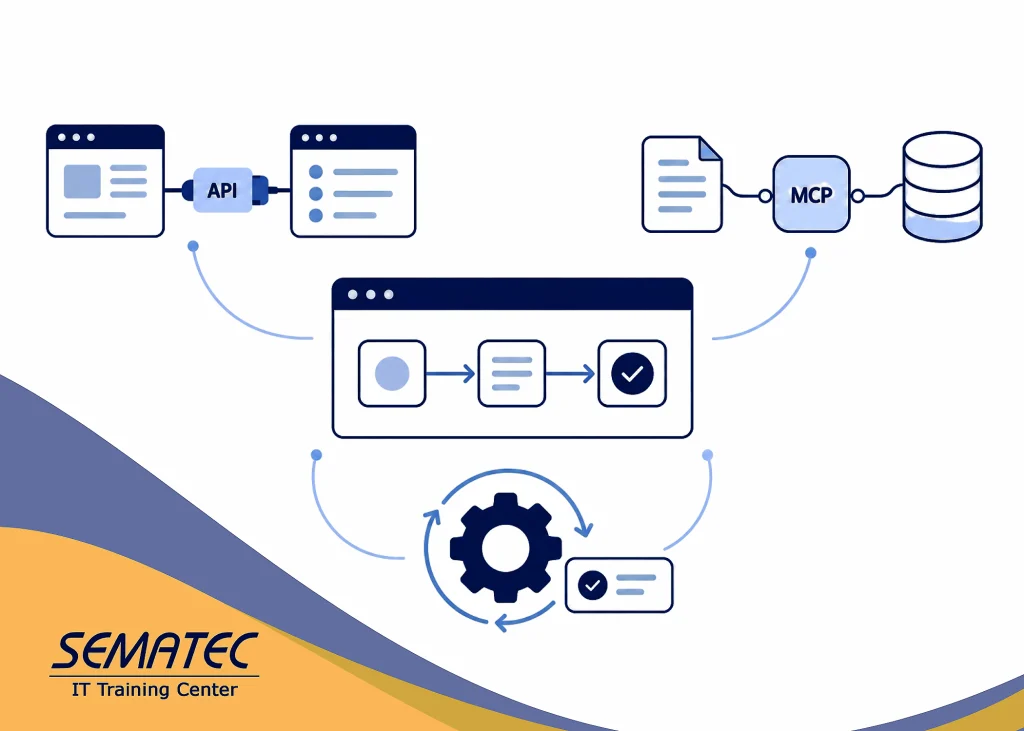
پروتکل MCP (Model Context Protocol)
پروتکل MCP (Model Context Protocol)
MCP مخفف Model Context Protocol و پروتکلی برای استانداردسازی ارتباط برنامههای هوش مصنوعی با ابزارها و منابع داده است. با استفاده از یک پیادهسازی سازگار با MCP، برنامه میتواند قابلیتهایی مانند دسترسی به منابع یا فراخوانی ابزارها را در قالبی مشخص در اختیار مدل یا دستیار قرار دهد.
برای مثال، یک محیط توسعه میتواند از طریق سرور MCP به ابزارها یا منابع مرتبط با پروژه متصل شود. MCP بهخودیخود مدل هوش مصنوعی یا ایجنت نیست؛ بلکه به برقراری ارتباط استاندارد کمک میکند. دسترسیها، احراز هویت و مجوزهای هر ابزار همچنان باید بهدرستی مدیریت شوند.
۵. اصطلاحات بازیابی اطلاعات و پایگاه دانش
تولید تقویتشده با بازیابی اطلاعات (RAG)
RAG مخفف Retrieval-Augmented Generation است. در این روش، سیستم پیش از تولید پاسخ، اطلاعات مرتبط را از منابعی مانند اسناد سازمانی، پایگاه دانش یا موتور جستوجو بازیابی میکند و آنها را در اختیار مدل قرار میدهد. هدف این است که پاسخ بر اطلاعات مرتبطتری تکیه کند.
برای مثال، یک مرکز آموزشی میتواند دستیار هوشمندی بسازد که به پرسشهای مربوط به دورهها با استفاده از اطلاعات رسمی دورهها پاسخ دهد. کیفیت RAG به آمادهسازی اسناد، روش بازیابی، مرتبطبودن نتایج و نحوه استفاده مدل از آنها وابسته است و بهتنهایی تضمینکننده صحت پاسخ نیست.
بردارسازی (Embedding)
Embedding روشی برای تبدیل دادههایی مانند متن یا تصویر به یک نمایش عددی برداری است. این بردارها میتوانند برخی ویژگیها و روابط معنایی داده را به شکلی نمایش دهند که برای محاسبات و مقایسه ماشینی مناسب باشد.
در جستوجوی معنایی، متن پرسش و اسناد به بردار تبدیل میشوند و سیستم میتواند با مقایسه آنها، محتواهای مرتبط را پیدا کند. کیفیت نتیجه به مدل Embedding، نوع داده، روش آمادهسازی متن و معیار شباهت بستگی دارد.
پایگاه داده برداری (Vector Database)
پایگاه داده برداری برای ذخیره، سازماندهی و جستوجوی بردارهای عددی طراحی شده است. این نوع پایگاه داده معمولاً قابلیت بازیابی بردارهای نزدیک به یک بردار پرسوجو را فراهم میکند و در جستوجوی معنایی و سیستمهای RAG کاربرد دارد.
برای مثال، میتوان محتوای مقالههای یک وبسایت را به بردار تبدیل کرد و در زمان پرسش کاربر، بخشهای مرتبط را بازیابی کرد. انتخاب پایگاه داده مناسب به حجم اطلاعات، سرعت مورد نیاز، هزینه و قابلیتهای فنی پروژه بستگی دارد.
جستوجوی معنایی (Semantic Search)
جستوجوی معنایی تلاش میکند نتایج را بر اساس مفهوم و منظور کاربر پیدا کند، نه صرفاً تطبیق دقیق واژهها. در این روش ممکن است از Embedding، مدلهای رتبهبندی یا ترکیبی از جستوجوی متنی و برداری استفاده شود.
برای نمونه، اگر کاربر درباره «روش کاهش زمان بارگذاری سایت» جستوجو کند، سیستم میتواند محتوایی درباره بهینهسازی سرعت وبسایت را نیز پیدا کند؛ حتی اگر عبارت دقیق کاربر در آن متن وجود نداشته باشد. جستوجوی معنایی در موتورهای جستوجوی داخلی و سامانههای بازیابی دانش کاربرد دارد.
تقسیمبندی اسناد (Chunking)
Chunking به تقسیم اسناد طولانی به قطعات کوچکتر گفته میشود تا ذخیرهسازی، بازیابی و پردازش آنها سادهتر شود. در سیستمهای RAG، قطعات متن معمولاً جداگانه به بردار تبدیل میشوند تا هنگام پرسش، بخشهای مرتبط بازیابی شوند.
اندازه قطعه و میزان همپوشانی میان قطعات بر کیفیت بازیابی تأثیر میگذارند. قطعات بسیار کوچک ممکن است زمینه لازم را از دست بدهند و قطعات بسیار بزرگ نیز ممکن است اطلاعات غیرمرتبط زیادی وارد پاسخ کنند. انتخاب روش مناسب به ساختار اسناد و نوع پرسشها بستگی دارد.
پایگاه دانش (Knowledge Base)
پایگاه دانش مجموعهای سازمانیافته از اطلاعات است که برای پاسخگویی، تصمیمگیری یا انجام وظایف در اختیار کاربران و سیستمها قرار میگیرد. این اطلاعات میتوانند شامل مستندات، راهنماها، پرسشهای متداول، دستورالعملها و اطلاعات ساختاریافته باشند.
یک دستیار هوش مصنوعی میتواند با اتصال به پایگاه دانش، پاسخهای مرتبط با محصولات یا فرایندهای یک سازمان را ارائه دهد. برای حفظ کیفیت پاسخها باید اطلاعات بهروز باشند، منابع نامعتبر مدیریت شوند و دسترسی به دادههای محرمانه محدود بماند.
اصطلاحات پردازش زبان، تصویر و صدا
۶. اصطلاحات پردازش زبان، تصویر و صدا
پردازش زبان طبیعی (Natural Language Processing یا NLP)
NLP شاخهای از هوش مصنوعی است که به پردازش و تحلیل زبان انسان توسط رایانه میپردازد. این حوزه وظایفی مانند طبقهبندی متن، استخراج اطلاعات، ترجمه، تحلیل احساسات و تشخیص موجودیتها را در بر میگیرد.
برای مثال، یک سیستم NLP میتواند پیامهای مشتریان را بر اساس موضوع دستهبندی کند یا نام افراد و سازمانها را از متن استخراج کند. مدلهای زبانی جدید بسیاری از این وظایف را انجام میدهند، اما NLP همچنان نام حوزهای گسترده از روشها و کاربردهای مرتبط با زبان است.
بینایی ماشین (Computer Vision)
Computer Vision حوزهای از هوش مصنوعی است که به تحلیل و تفسیر تصاویر و ویدئوها توسط رایانه میپردازد. وظایف آن میتواند شامل تشخیص اشیا، دستهبندی تصاویر، شناسایی ناهنجاریها و استخراج اطلاعات بصری باشد.
برای مثال، سیستم بینایی ماشین میتواند قطعات معیوب را در خط تولید شناسایی کند یا اطلاعات موجود در تصویر یک سند را تحلیل کند. عملکرد این سیستمها به کیفیت داده، شرایط تصویربرداری، نوع مدل و هدف کاربرد وابسته است.
تولید تصویر از متن (Text-to-Image)
Text-to-Image به فناوریهایی گفته میشود که با دریافت توضیحات متنی، تصویر تولید میکنند. کاربر میتواند موضوع، سبک هنری، ترکیببندی و جزئیات مورد نظر را توصیف کند و مدل بر اساس آن خروجی تصویری بسازد.
این فناوری در طراحی مفهومی، تولید تصاویر تبلیغاتی و تهیه ایدههای بصری کاربرد دارد. نتیجه ممکن است دقیقاً با درخواست مطابقت نداشته باشد؛ بنابراین در کارهای حرفهای باید خروجی بررسی و در صورت نیاز اصلاح شود. همچنین استفاده تجاری از تصاویر باید با توجه به شرایط سرویس و حقوق مرتبط انجام گیرد.
تبدیل متن به گفتار (Text-to-Speech یا TTS)
TTS فناوری تبدیل متن نوشتاری به صدای گفتاری است. این فناوری میتواند برای تولید صدای طبیعیتر، خواندن محتوای دیجیتال و ساخت خروجی صوتی از متن استفاده شود.
از کاربردهای آن میتوان به دستیارهای صوتی، ابزارهای دسترسپذیری و تولید نسخه صوتی محتوا اشاره کرد. کیفیت تلفظ، پشتیبانی از زبان، انتخاب صدا و امکان کنترل لحن در سرویسهای مختلف متفاوت است.
تبدیل گفتار به متن (Speech-to-Text یا STT)
Speech-to-Text فناوری تبدیل صدای گفتاری به متن نوشتاری است. این سیستمها با تحلیل سیگنال صوتی، واژهها و جملات گفتهشده را تشخیص میدهند و میتوانند برای پیادهسازی فایل صوتی یا تبدیل گفتار زنده به متن استفاده شوند.
این فناوری در تهیه متن جلسات، زیرنویس و جستوجو در محتوای صوتی کاربرد دارد. دقت خروجی به کیفیت صدا، نویز محیط، لهجه، زبان و مدل مورد استفاده وابسته است و در کاربردهای مهم ممکن است به بازبینی انسانی نیاز باشد.
۷. اصطلاحات هوش مصنوعی در برنامهنویسی
ایجنت برنامهنویسی (AI Coding Agent)
AI Coding Agent عاملی هوشمند است که برای انجام وظایف توسعه نرمافزار طراحی شده است. این عامل ممکن است کد پروژه را بررسی کند، فایلها را بخواند یا تغییر دهد، ابزارهای توسعه را اجرا کند و در صورت دسترسی، تستها را برای ارزیابی نتیجه به کار بگیرد.
برای مثال، میتوان از یک ایجنت خواست قابلیت مشخصی را در پروژه React پیادهسازی کند. ایجنت ممکن است چند فایل را تغییر دهد و تست اجرا کند، اما نتیجه باید بررسی شود. دسترسی به ترمینال، فایلها و مخزن کد باید متناسب با نیاز و سطح اعتماد تنظیم شود.
وایب کدنویسی (Vibe Coding)
Vibe Coding اصطلاحی برای شیوهای از توسعه نرمافزار است که در آن توسعهدهنده با توصیف نیازها به زبان طبیعی، بخش زیادی از تولید کد را به ابزار هوش مصنوعی واگذار میکند. در این روش، کاربر میتواند بهجای نوشتن دستی تمام کدها، روی توصیف رفتار مورد انتظار و اصلاح تدریجی خروجی تمرکز کند.
این رویکرد برای ساخت نمونه اولیه و آزمایش ایدهها مفید است، اما کد تولیدشده ممکن است دارای خطا، ضعف امنیتی یا ساختار نامناسب باشد. در پروژههای واقعی، شناخت مبانی برنامهنویسی، بازبینی کد، تست، کنترل نسخه و توجه به امنیت همچنان ضروری است.
۸. ارزیابی و امنیت در سیستمهای هوش مصنوعی
ارزیابی (Evaluation یا Evals)
Evaluation به فرایند سنجش کیفیت و عملکرد یک مدل یا سیستم هوش مصنوعی گفته میشود. ارزیابی میتواند بررسی صحت پاسخها، مرتبطبودن خروجی، پیروی از دستورالعملها، سرعت، هزینه یا میزان موفقیت در انجام وظیفه را شامل شود.
برای مثال، پیش از انتشار یک دستیار پشتیبانی، میتوان مجموعهای از پرسشهای واقعی را آماده کرد و بررسی کرد که سیستم چقدر درست و کامل پاسخ میدهد. ارزیابی منظم به شناسایی ضعفها و مقایسه نسخههای مختلف کمک میکند، اما معیارها باید با هدف و شرایط واقعی استفاده هماهنگ باشند.
بنچمارک (Benchmark)
Benchmark به مجموعه آزمونها یا معیارهایی گفته میشود که برای سنجش و مقایسه عملکرد مدلها و سیستمها استفاده میشوند. بنچمارک میتواند توانایی مدل در استدلال، کدنویسی، پاسخگویی یا انجام وظایف مشخص را بررسی کند.
نتایج یک بنچمارک بهتنهایی نشان نمیدهد که کدام مدل برای تمام کاربردها بهتر است. نوع آزمون، دادههای مورد استفاده، روش امتیازدهی و شباهت آزمون به نیاز واقعی باید در زمان مقایسه در نظر گرفته شوند.
تزریق پرامپت (Prompt Injection)
Prompt Injection نوعی تلاش برای دستکاری رفتار سیستم هوش مصنوعی از طریق ورودیهای طراحیشده است. این ورودی ممکن است مستقیماً از کاربر دریافت شود یا در یک صفحه وب، سند یا منبع خارجی وجود داشته باشد که سیستم آن را پردازش میکند.
برای مثال، یک سند مخرب ممکن است تلاش کند دستیار متصل به منابع سازمانی را به افشای اطلاعات یا نادیدهگرفتن دستورالعملها ترغیب کند. کاهش خطر به طراحی امن سیستم، محدودکردن دسترسی ابزارها، جداسازی داده از دستورها، بررسی خروجی و جلوگیری از اجرای اقدامات حساس بدون تأیید نیاز دارد.
محدودیتها و کنترلهای ایمنی (Guardrails)
Guardrails مجموعهای از قواعد و سازوکارهای کنترلی است که برای محدودکردن رفتار سیستم هوش مصنوعی و کاهش خطرهای احتمالی به کار میرود. این کنترلها ممکن است ورودیها و خروجیها را بررسی کنند، دسترسی به ابزارها را محدود کنند یا برخی اقدامات را به تأیید انسان وابسته سازند.
برای مثال، در یک ایجنت متصل به پایگاه داده میتوان دسترسی را به عملیات خواندن محدود کرد یا پیش از حذف اطلاعات، تأیید کاربر را الزامی دانست. Guardrails به کاهش ریسک کمک میکنند، اما بهتنهایی امنیت کامل را تضمین نمیکنند و باید بخشی از طراحی امنیتی جامع سیستم باشند.
تفاوت Fine-tuning و RAG
Fine-tuning و RAG دو روش متفاوت برای سازگارکردن یک مدل با کاربرد خاص هستند. در Fine-tuning، مدل با دادههای تکمیلی آموزش میبیند و پارامترهای آن تغییر میکنند. در RAG، مدل در زمان پاسخگویی به اطلاعات بازیابیشده از منابع خارجی دسترسی پیدا میکند و لازم نیست برای هر تغییر در اسناد، مدل دوباره آموزش ببیند.
اگر هدف، پاسخگویی بر اساس مستندات بهروز سازمان باشد، RAG میتواند گزینه مناسبی باشد. اگر هدف، تغییر رفتار مدل یا بهبود عملکرد آن در یک وظیفه مشخص باشد، Fine-tuning ممکن است مفید باشد. این دو روش میتوانند در برخی پروژهها در کنار یکدیگر استفاده شوند و انتخاب نهایی به نوع مسئله، دادهها، هزینه و نیازهای نگهداری بستگی دارد.
جمعبندی
آشنایی با اصطلاحات هوش مصنوعی به درک بهتر ابزارها و انتخاب راهکار مناسب کمک میکند. مفاهیمی مانند LLM، Prompt و Context بیشتر به نحوه کار با مدلها مربوط هستند؛ اصطلاحاتی مانند Skill، Tool Calling و Agent به طراحی سیستمهای هوشمند و انجام وظایف ارتباط دارند؛ و مفاهیمی مانند RAG، Embedding و Vector Database در بازیابی اطلاعات و ساخت دستیارهای متکی به منابع تخصصی کاربرد دارند.
برای شروع، بهتر است ابتدا نحوه کار مدلهای زبانی و پرامپتنویسی را یاد بگیرید، سپس با API و ابزارها آشنا شوید و در ادامه به سراغ ساخت گردش کارها و ایجنتهای هوشمند بروید. درک تفاوت این مفاهیم به شما کمک میکند بهجای استفاده سطحی از ابزارهای هوش مصنوعی، راهکارهایی متناسب با نیازهای واقعی طراحی کنید.