آموزش راهاندازی و اجرای Ollama و Hermes به صورت لوکال

آموزش راهاندازی Ollama و Hermes؛ چطور LLM لوکال رو روی سیستم خودمون اجرا کنیم؟
توی این یکی دو سال اخیر، یکی از جذابترین و خفنترین اتفاقات دنیای هوش مصنوعی این بوده که بالاخره تونستیم مدلهای زبانی بزرگ یا همون LLMها رو روی سیستمهای شخصی و سرورهای خودمون اجرا کنیم! قدیما اگه میخواستیم از یه هوش مصنوعی غولآخر استفاده کنیم، حتماً باید دستبهدامن سرویسهای ابری و API شرکتهای بزرگ میشدیم. اما حالا به لطف مدلهای متنباز (Open-Source)، قویتر شدن سختافزارها و تکنیکهای توپی مثل Quantization (کوانتایزیشن)، راحت میتونیم این مدلها رو روی لپتاپ یا سرور شرکتمون بالا بیاریم.
وقتی از سرویسهای ابری استفاده میکنیم، تمام دیتاها و پرامپتهای ما میره روی سرورهای خارجی پردازش میشه. این کار برای خیلی از شرکتها و پروژهها یعنی کابوس حریم خصوصی، امنیت دیتا و البته هزینههای دلاری سنگین! از اون طرف هم اجرای محلی بدون شناخت درست از سختافزار و انتخاب مدل مناسب، فقط سیستم رو قفل میکنه و نتیجهای نداره.
اینجاست که بحث Local LLM (اجرای محلی مدلهای زبانی) میاد وسط. با این روش همه دیتاها پیش خودتون میمونه. ابزار قدرتمندی مثل Ollama دانلود و اجرای مدلها رو مثل آب خوردن میکنه، مدلهایی مثل Hermes برای دستورپذیری و فراخوانی ابزارها (Tool Calling) فوقالعادهان و ابزاری به اسم LLM Router هم مثل یه پلیس راهنماییرانندگی هوشمند، درخواستها رو بین مدلهای مختلف تقسیم میکنه.
توی این مقاله قرار نیست فقط قشنگ حرف بزنیم؛ قراره قدمبهقدم ببینیم چطور میشه یه زیرساخت هوش مصنوعی محلی، امن و سریع رو روی سیستم راهاندازی کرد.
اجزای اصلی برای راهاندازی یک Local LLM خفن
برای اینکه سیستم بدون تیک و دردسر کار کنه، این ۴ تا بخش باید مثل ساعت با هم هماهنگ باشن:
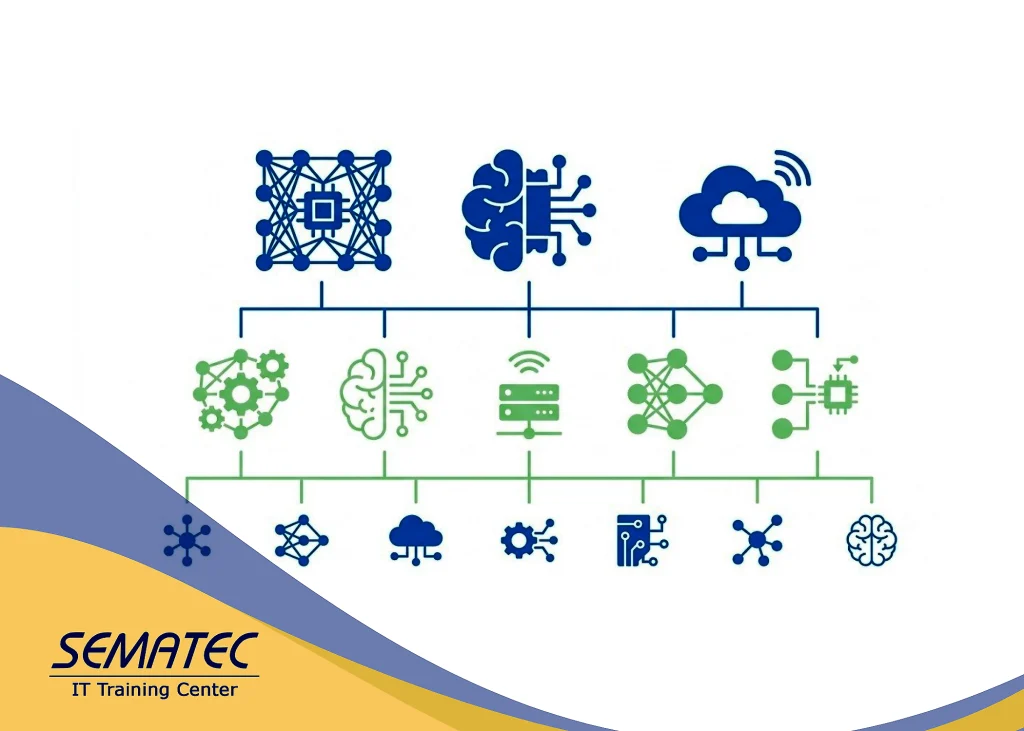
اکوسیستم Local LLM؛ هماهنگی ابزارهای مدیریت مدل، شبکههای عصبی و سختافزار برای اجرای روان هوش مصنوعی.
- زیرساخت و سختافزار: همون موتور ماشینه! منابعی مثل کارت گرافیک (VRAM) و رم رو تأمین میکنه تا مدل بتونه نفس بکشه.
- ابزار Ollama: ابزار Ollama: مثل یه مدیریتکننده همهفنحریفه که در فرآیندهای LLMOps مدلها رو دانلود، اجرا و مدیریت میکنه و بهتون API میده.
- مدل Hermes: یه مدل فاینتیونشده و باهوشه که حرف گوشکردنش (Instruction Following) عالیه و قشنگ ابزارها رو متصل میکنه.
- روتر هوش مصنوعی (LLM Router): لایه مدیریت کارهاست که تصمیم میگیره کدوم پرامپت بره سمت مدل محلی و کدوم بره سمت مدل ابری.
سختافزار مورد نیاز؛ سیستم من میکشه؟
مهمترین سوالی که اول کار پیش میاد اینه: «اصلاً سیستم من میتونه LLM محلی بکشه؟» پاسخ کوتاه اینه: بله، اما بستگی به فاکتورهایی مثل تعداد پارامترهای مدل، میزان کوانتایزیشن، طول کانتکست (Context Window) و قدرت کارت گرافیکتون داره.
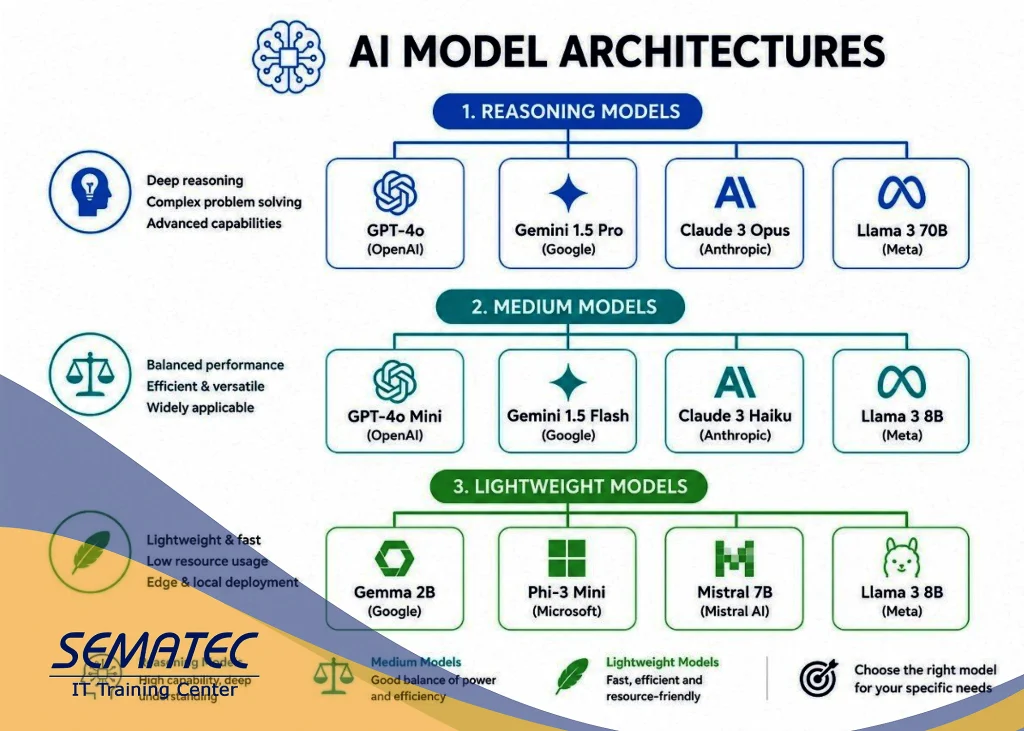
دستهبندی مدلهای AI؛ انتخاب هوشمندانه بین مدلهای سبک، میانرده و سنگین بر اساس توان سختافزاری و نیاز کاری.
۱. بررسی منابع سختافزاری
مدلهای کوچیک (حدود ۳ تا ۴ میلیارد پارامتری) با کوانت ۴ بیتی، حتی روی سیستمهای معمولی و لپتاپهای معمولی هم مثل بلبل کار میکنن.
برای مدلهای محبوب ۷ تا ۸ میلیارد پارامتری، داشتن یه کارت گرافیک با حداقل ۸ گیگابایت VRAM عالیه و سرعت خیلی خوبی بهتون میده. البته مدلهای غولپیکر (مثل ۷۰ میلیارد پارامتری به بالا) زیرساختهای خفنتر، چند تا کارت گرافیک یا سیستمهایی با رم یکپارچه بالا (مثل مکبوکهای سری M) میخوان.
۲. کوانتایزیشن (Quantization) چیه و به چه دردی میخوره؟
به زبان ساده، کوانتایزیشن یعنی فشردهسازی وزنهای مدل! با این تکنیک، حجم مدلی که مثلاً ۱۶ گیگ رم میخواسته رو میارن روی ۴ یا ۵ گیگ. نسخه ۴ بیتی مدلها (4-bit) معمولاً بهترین تعادل رو بین حجم، سرعت و کیفیت ایجاد میکنه.
۳. انتخاب مدل بر اساس کار واقعی (Workload)
جوگیر نشید و نرید سراغ سنگینترین مدل ممکن! برای کارهایی مثل خلاصهسازی، بازنویسی، تولید کد یا چتباتهای عمومی، مدلهای میانرده مثل آب خوردن جواب میدن. مدلهای سنگینتر فقط زمانی لازمه که استدلالهای چندمرحلهای پیچیده یا کارهای خیلی تخصصی دارید.
کار با Ollama؛ غول چراغ جادوی اجرای محلی
اگر قبلاً با Docker کار کرده باشید، عاشقی در نگاه اول با Ollama رو تجربه میکنید! این ابزار تمام پیچیدگیهای فنی اجرای مدل رو قایم میکنه و بهتون اجازه میده با چند تا دستور ساده توی ترمینال، مدل رو دانلود و اجرا کنید.
نصب و راه اندازی
راحت روی ویندوز، لینوکس و مک نصب میشه. بعد از نصب، یه سرویس پشت صحنه بالا میاد که API محلی (کاملاً سازگار با استاندارد OpenAI) رو اختیارتون میذاره. این یعنی هر نرمافزاری که با API کار میکنه رو میتونید فقط با تغییر یک آدرس (Base URL)، به سیستم محلی خودتون وصل کنید!
قابلیتهای کلیدی Ollama:
- دانلود و اجرای راحت مدلها با یک دستور (ollama run)
- مدیریت کامل مدلهای نصبشده روی سیستم
- امکان سفارشیسازی رفتار مدل با Modelfile
- ارائه API پرسرعت برای برنامهنویسها
- استفاده هوشمندانه از حداکثر توان CPU و GPU
- پشتیبانی کامل از مدلهای فشردهشده (Quantized)
استفاده تیمی و شرکتی
فقط شما نیستید که میتونید ازش استفاده کنید! میتونید Ollama رو روی سرور شرکت بزنید و کل تیم بهش وصل بشن. حتی با ابزارهای خوشساختی مثل Open WebUI میتونید یه رابط کاربری دقیقا شبیه ChatGPT برای کارمنداتون بسازید تا بدون نیاز به کدنویسی باهاش چت کنن.
مدل Hermes؛ دستیار باهوش و حرفگوشکن
توی دنیای مدلهای متنباز، بعضی مدلها به اصطلاح Fine-tuned شدن؛ یعنی برای کارهای خاصی تربیتشون کردن. خانواده مدلهای Hermes دقیقاً از همین دستهست.
تمرکز اصلی Hermes روی دنبال کردن دقیق دستورات (Instruction Following)، چت طبیعی و از همه مهمتر فراخوانی ابزارها (Tool Calling) هست. یعنی اگر میخواید هوش مصنوعی به دیتابیس وصل بشه یا API دیگهای رو صدا بزنه، هرمس یه گزینه فوقالعادهست.
تست روی زبان فارسی؛ کلاهتونو قاضی کنید!
مدلهای انگلیسی خیلی قشنگ حرف میزنن، اما آیا فارسی هم بلدن؟ قبل از اینکه Hermes رو ببرید توی دل پروژهتون، حتماً با پرامپتهای واقعی فارسی تستش کنید. حواستون به این موارد باشه:
- روانی و طبیعی بودن متن فارسی تولید شده
- درک دقیق دستورات پیچیده فارسی
- توانایی خلاصهسازی درست و بدون چرندگویی
- عملکرد در چتهای چندمرحلهای و طولانی
مدیریت هوشمند مدلها با LLM Router
وقتی کار بالا میگیره، قطعاً یک مدل جوابگوی همه نیازها نیست. مثلاً برای یه پاسخ ساده حیف نیست مدل سنگین رو درگیر کنیم؟ اینجاست که LLM Router یا گیتوی (Gateway) میاد توی بازی.
روتر دقیقاً مثل یه ترافیککنترلر عمل میکنه؛ برنامه شما پرامپت رو میده به روتر، و روتر بر اساس فاکتورهایی مثل: نوع سوال، سرعت پاسخدهی، ترافیک سرور و هزینه تصمیم میگیره درخواست رو بفرسته برای Ollama (مدل محلی) یا مثلاً بفرستهش سمت یه مدل ابری قدرتمند!
ترکیب محلی و ابری (معماری ترکیبی یا Hybrid AI)
چرا باید خودمون رو محدود کنیم؟ با ترکیب Ollama و مدلهای ابری از طریق روتر، میتونید یه سیستم هیبریدی و زرنگ بسازید:
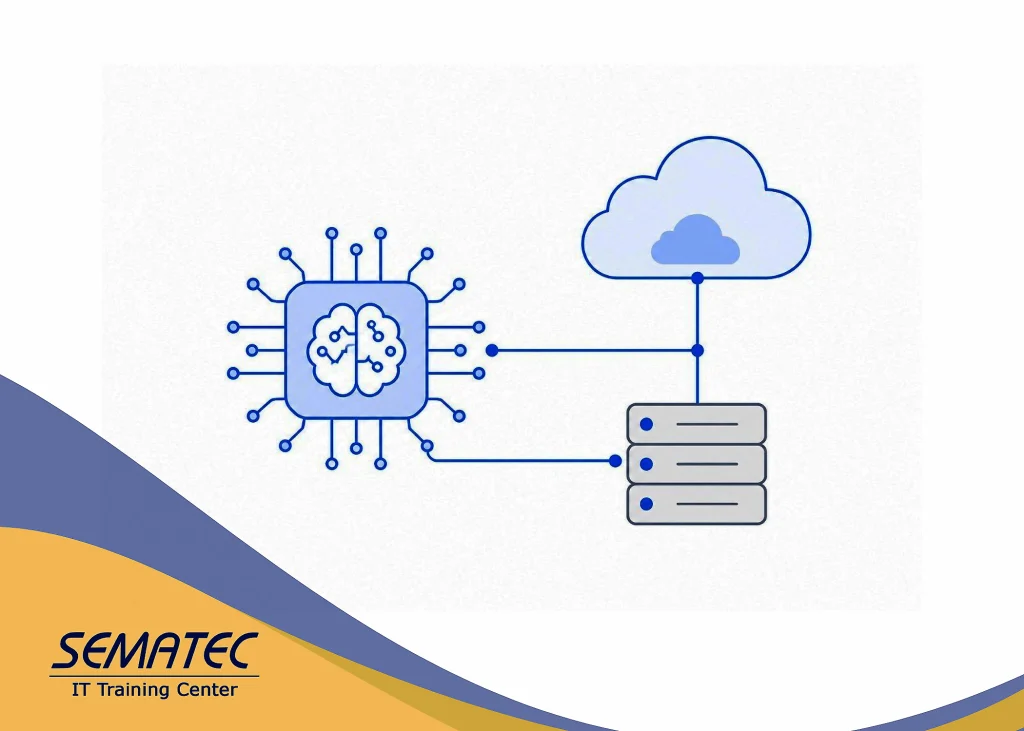
معماری ترکیبی (Hybrid AI)؛ مدیریت و هدایت هوشمند درخواستها بین سرور محلی و مدلهای ابری.
- پرامپتهای حساس و محرمانه، دیتای مشتریان و کارهای پرحجم: میره روی Ollama بهصورت محلی (هزینه صفر، امنیت ۱۰۰٪).
- کارهای بینهایت پیچیده و تحلیلهای سنگین: میره سمت مدلهای ابری قدرتمند.
مقایسه سریع Local LLM و Cloud API:
| معیار | مدل محلی (Local LLM) | سرویس ابری (Cloud API) |
|---|---|---|
| حریم خصوصی و امنیت | کنترل ۱۰۰٪ روی اطلاعات | وابسته به قوانین شرکت ارائهدهنده |
| هزینهها | فقط خرید سختافزار (بدون هزینه پردازش) | پرداخت دلاری به ازای هر توکن/مصرف |
| کارکرد آفلاین | کاملاً بدون نیاز به اینترنت | قطع بشه، همهچی هوا میره! |
| ساده بودن مقیاسپذیری | نیازمند ارتقای سختافزار | خیلی ساده با شارژ اکانت |
چالشهای اجرای محلی و چگونگی حل آنها
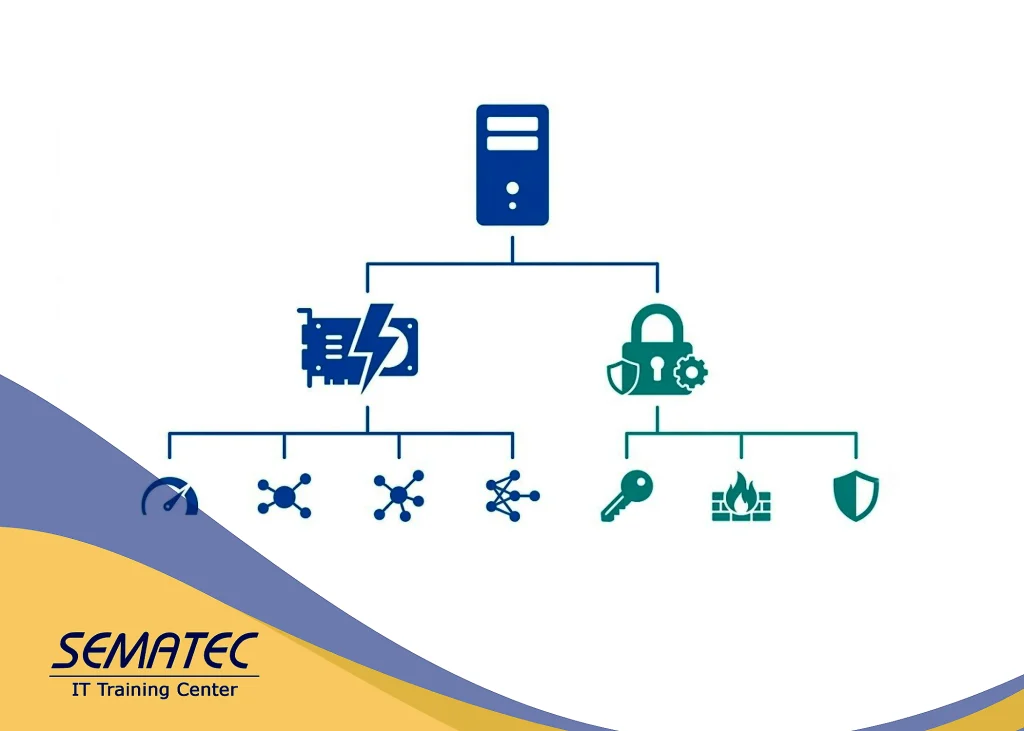
دو رکن اصلی اجرای محلی: تخصیص منابع کارت گرافیک (GPU) برای سرعت بالارفتن پاسخدهی و ایجاد فایروال جهت تامین امنیت شبکه.
اجرای محلی هم همیشه گل و بلبل نیست! باید مراقب این چند تا چالش هم باشید:
۱. پر شدن رم و داغ کردن سیستم: مدلهای سنگین منابع رو میبلعن. حتماً از مدلهای کوانتایز شده (4-bit) متناسب با کارت گرافیکتون استفاده کنید.
۲. کمبود فضای هارد: فایل مدلها حجم زیادی میگیرن. هر چند وقت یکبار مدلهای بلااستفاده رو با دستورات Ollama پاک کنید.
۳. امنیت شبکه: اگر Ollama رو روی سرور شرکت گذاشتید، حتماً روش فایروال (Firewall) و احراز هویت بذارید تا از بیرون کسی بهش دسترسی نداشته باشه.
سوالات متداول (FAQ)
آیا بدون کارت گرافیک (GPU) هم میشه LLM محلی رو اجرا کرد؟
بله! Ollama میتونه مدلها رو روی CPU هم اجرا کنه. اما خدایی سرعتش پایینتره و برای کارهای فوری ممکنه کلافتون کنه.
آیا مدل محلی میتونه جایگزین کامل ChatGPT بشه؟
برای کارهای روزمره مثل تولید محتوا، کدنویسی، خلاصه کردن و چتباتها بله کاملاً جواب میده. اما برای تحلیلهای فوقالعاده پیچیده یا دیتای آنلاین، مدلهای ابری هنوز کمی جلوترن.
چطور چتبات محلی رو با ظاهر گرافیکی راه بیندازیم؟
کافیه ابزار رایگان و متنباز Open WebUI رو دانلود و به Ollama متصل کنید تا یه محیطی دقیقاً شبیه به وبسایت ChatGPT رو روی سیستم خودتون داشته باشید.
جمعبندی
راهاندازی هوش مصنوعی محلی دیگه یه رویای دور از دسترس نیست. با فرمول زیر میتونید یه سیستم بینقص داشته باشید:
- انتخاب سختافزار مناسب بر اساس فشار کاری (Workload) واقعی.
- نصب Ollama برای مدیریت و اجرای راحت مدلها.
- تست مدلهایی مثل Hermes برای کارهای اجرایی و ابزار محور.
- استفاده از LLM Router برای ترکیب قدرت مدلهای محلی و ابری.
بهترین کار اینه که از همین امروز با یه مدل کوچک روی سیستم خودتون شروع کنید، بازدهی و سرعتش رو بسنجید و بعد برای سرورها یا زیرساختهای بزرگتر تصمیمگیری کنید!