یادگیری ماشین در امنیت شبکه: راهکار هوشمند تشخیص رفتارهای غیرعادی

شبکههای سازمانی امروزی، حجم بسیار زیادی از ارتباطات را در هر لحظه مدیریت میکنند. کاربران به سامانههای داخلی متصل میشوند، سرورها با یکدیگر ارتباط دارند، شعب سازمان از طریق لینکهای WAN با مرکز داده در تماس هستند و سرویسهای ابری نیز بخشی از ترافیک روزمره را تشکیل میدهند. در کنار این ارتباطات عادی، ممکن است فعالیتهای مخرب، خطاهای انسانی، نقص نرمافزاری یا رفتارهای غیرمنتظره نیز در شبکه رخ دهد.
یکی از چالشهای اصلی تیمهای زیرساخت، شناسایی رفتارهای غیرعادی در میان این حجم عظیم از داده است. امروزه بهکارگیری یادگیری ماشین در امنیت شبکه به سازمانها کمک میکند تا با تحلیل هوشمند الگوها، ناهنجاریها را در کمترین زمان ممکن تشخیص دهند. در روشهای سنتی، مدیران شبکه معمولاً بر اساس چند قانون ثابت تصمیمگیری میکنند؛ برای مثال، اگر یک IP در مدت یک دقیقه به بیش از ۱۰۰ پورت متصل شد، هشدار صادر شود. این قوانین در برخی شرایط مفید هستند، اما همیشه نمیتوانند پیچیدگی رفتار واقعی شبکه را پوشش دهند.
برای نمونه، اسکنر آسیبپذیری سازمانی نیز ممکن است در مدت کوتاهی به تعداد زیادی پورت متصل شود، اما این فعالیت مجاز است. از طرف دیگر، یک مهاجم ممکن است با سرعت پایین و در بازههای زمانی طولانی فعالیت کند تا از آستانههای ثابت عبور نکند. بنابراین، استفاده از روشهایی که بتوانند الگوی عادی شبکه را یاد بگیرند و انحراف از آن را تشخیص دهند، اهمیت زیادی دارد.
در این مقاله، من به بررسی کاربرد یادگیری ماشین در تشخیص رفتارهای غیرعادی ترافیک شبکه میپردازم. در این راهکار، دادههایی مانند NetFlow، IPFIX، Syslog و اطلاعات مربوط به ارتباطات شبکه جمعآوری میشوند و سپس الگوریتمهای یادگیری ماشین، الگوهای عادی و غیرعادی را شناسایی میکنند.
هدف این مقاله، ارائه یک راهکار عملی و قابل توسعه برای سازمانهایی است که میخواهند از تحلیل هوشمند دادهها برای افزایش امنیت، کاهش زمان تشخیص رخداد و بهبود عملکرد تیمهای شبکه استفاده کنند.
چرا روشهای سنتی در امنیت شبکه دیگر کافی نیستند؟
روشهای مبتنی بر قانون، یکی از قدیمیترین و همچنان کاربردیترین ابزارهای تشخیص تهدید هستند. در این روش، کارشناسان امنیت قواعد مشخصی تعریف میکنند؛ مانند:
اگر تعداد اتصالهای یک IP در یک دقیقه بیشتر از ۱۰۰۰ بود، هشدار بده
یا:
اگر یک سیستم به بیش از 50 پورت مقصد متصل شد، احتمال Port Scan را اعلام کن.
این قواعد ساده، قابل فهم و قابل ممیزی هستند؛ اما محدودیتهایی دارند.
محدودیت اول: وابستگی به آستانههای ثابت
رفتار شبکه در همه زمانها یکسان نیست. در ساعات کاری، حجم ارتباطها بیشتر است. در ساعات شب، ممکن است عملیات Backup انجام شود. اگر یک آستانه برای کل شبانهروز تعریف شود، احتمال هشدار اشتباه افزایش مییابد.
محدودیت دوم: ناتوانی در شناسایی حملات آهسته
برخی مهاجمان تلاش میکنند فعالیت خود را در بازه زمانی طولانی و با سرعت کم انجام دهند. برای مثال، مهاجم ممکن است هر ۳۰ ثانیه فقط یک پورت را بررسی کند. این رفتار ممکن است هیچگاه از آستانه ۱۰۰ اتصال در دقیقه عبور نکند، اما در طول چند ساعت، یک الگوی شناسایی شبکه ایجاد میکند.
محدودیت سوم: تفاوت نقش داراییها
ارسال ۲۰ گیگابایت داده برای یک سرور Backup ممکن است طبیعی باشد، اما همین مقدار برای یک لپتاپ کاربری بسیار غیرعادی است. قانون ثابت نمیتواند همیشه نقش دارایی را بهدرستی در نظر بگیرد.
محدودیت چهارم: تغییر رفتار شبکه
با اضافهشدن سرویسهای جدید، مهاجرت به Cloud، تغییر ساعات کاری یا ایجاد شعب جدید، رفتار عادی شبکه نیز تغییر میکند. قوانینی که در گذشته مناسب بودهاند، ممکن است پس از مدتی کارایی خود را از دست بدهند.
اینجاست که نقش یادگیری ماشین در امنیت شبکه برجسته میشود؛ زیرا این فناوری توانایی یادگیری الگوهای متغیر و تحلیل دادههای تاریخی را دارد.
مفهوم تشخیص ناهنجاری شبکه با یادگیری ماشین
مفهوم تشخیص ناهنجاری شبکه با یادگیری ماشین
در تشخیص ناهنجاری، هدف این نیست که همیشه نوع دقیق حمله را مشخص کنیم. هدف اولیه، پیدا کردن نمونههایی است که نسبت به رفتار عادی تفاوت دارند.
فرض کنیم برای هر سیستم شبکه، ویژگیهایی مانند موارد زیر را در هر بازه پنجدقیقهای ثبت کنیم:
- تعداد ارتباطهای خروجی
- تعداد IPهای مقصد
- تعداد پورتهای مقصد
- مجموع بایتهای ارسالشده
- مجموع بایتهای دریافتشده
- میانگین مدت ارتباط
- تعداد ارتباطهای TCP
- تعداد ارتباطهای UDP
- تعداد خطاها
- نسبت ترافیک داخلی به خارجی
هر بازه زمانی را میتوان به یک رکورد عددی تبدیل کرد. سپس الگوریتم یادگیری ماشین میتواند تشخیص دهد کدام رکورد شبیه رفتار معمول و کدام رکورد متفاوت است.
برای مثال:
Host: 10.10.20.45
Flows: 1350
Unique Destinations: 420
Unique Ports: 180
Outbound Bytes: 7.8 GB
Business Hour: No
چنین رکوردی برای یک لپتاپ کاربری میتواند بسیار غیرعادی باشد؛ اما اگر همین اطلاعات متعلق به یک سرور Proxy یا سامانه Backup باشد، ممکن است طبیعی تلقی شود. بنابراین، یادگیری ماشین باید در کنار اطلاعات داراییها و نقش سیستمها استفاده شود.
منابع داده کلیدی برای مدلهای یادگیری ماشین در امنیت شبکه
رکوردهای NetFlow و IPFIX
NetFlow معمولاً مهمترین منبع داده برای این پروژه است. رکوردهای NetFlow اطلاعاتی درباره الگوی جریانها ارائه میدهند، بدون آنکه لازم باشد محتوای کامل بستهها ذخیره شود.
ویژگیهای قابل استخراج از NetFlow عبارتاند از:
- تعداد Flowهای ایجادشده
- تعداد مقصدهای منحصربهفرد
- تعداد پورتهای منحصربهفرد
- حجم کل بایتها
- حجم کل بستهها
- میانگین اندازه بسته
- میانگین مدت ارتباط
- نسبت ارتباطهای داخلی و خارجی
- تعداد مقصدهای جغرافیایی مختلف
دادههای Syslog
Syslog میتواند اطلاعات تکمیلی ارائه کند، مانند:
- ورود ناموفق
- تغییرات پیکربندی
- قطع و وصل Interface
- خطاهای احراز هویت
- تغییرات Routing
- رخدادهای ACL
- هشدارهای Control Plane
ترکیب NetFlow و Syslog باعث میشود مدل فقط به رفتار ترافیکی وابسته نباشد.
اطلاعات داراییها و نقش سیستمها
اطلاعاتی مانند نام سیستم، نوع دارایی، واحد سازمانی، موقعیت جغرافیایی، سطح حساسیت و مالک سرویس نیز اهمیت زیادی دارند.
برای مثال:
- رفتار یک Domain Controller با لپتاپ کاربر یکسان نیست.
- سرور Backup معمولاً در ساعات خاصی ترافیک بالایی دارد.
- تجهیزات مانیتورینگ ممکن است به صدها سیستم متصل شوند.
- سرور وب باید ارتباطهای بیشتری از یک سیستم اداری داشته باشد.
بدون این اطلاعات، مدل ممکن است بسیاری از فعالیتهای مجاز را بهعنوان ناهنجاری تشخیص دهد.
ساخت و انتخاب ویژگیها (Feature Engineering)
یکی از مهمترین مراحل پروژه، انتخاب و ساخت Featureهای مناسب است. اگر ویژگیها بهدرستی انتخاب نشوند، حتی بهترین الگوریتم نیز نتیجه قابل اعتمادی ارائه نمیدهد.
برخی ویژگیهای مهم عبارتاند از:
| ویژگی | کاربرد |
| Flow Count | اندازهگیری تعداد ارتباطها |
| Unique Destination Count | شناسایی ارتباط با مقصدهای متعدد |
| Unique Port Count | تشخیص اسکن پورت |
| Total Bytes | شناسایی انتقال حجیم داده |
| Average Duration | بررسی نوع رفتار ارتباط |
| Failed Connection Ratio | شناسایی ارتباطهای ناموفق |
| External Traffic Ratio | بررسی ترافیک خارجی |
| Night Activity | بررسی فعالیت خارج از ساعات کاری |
| Destination Entropy | اندازهگیری پراکندگی مقصدها |
آنتروپی مقصدها
آنتروپی میتواند میزان پراکندگی ارتباطها را نشان دهد. اگر یک سیستم همیشه به دو یا سه مقصد مشخص متصل شود، آنتروپی آن پایین است. اما اگر با تعداد زیادی مقصد مختلف ارتباط بگیرد، آنتروپی افزایش مییابد.
این ویژگی در تشخیص رفتارهایی مانند اسکن، انتشار بدافزار و ارتباط با مقصدهای متعدد مفید است.
مثال عینی
یک سرور DNS ممکن است روزانه به صدها مقصد متصل شود؛ بنابراین تعداد مقصدهای زیاد بهتنهایی نشانه حمله نیست. اما اگر یک لپتاپ معمولی که در حالت عادی به ۲۰ مقصد متصل میشود، ناگهان به ۵۰۰ مقصد مختلف ارتباط برقرار کند، این تغییر باید بررسی شود.
برترین الگوریتمهای یادگیری ماشین در امنیت شبکه
برترین الگوریتمهای یادگیری ماشین در امنیت شبکه
الگوریتم Isolation Forest
Isolation Forest یکی از الگوریتمهای مناسب برای شناسایی دادههای غیرعادی است. ایده اصلی آن این است که دادههای غیرعادی معمولاً با تعداد تقسیمهای کمتری از دادههای عادی جدا میشوند.
مزایای این الگوریتم:
- مناسب برای دادههای بدون برچسب
- سرعت مناسب
- قابل استفاده برای حجم زیاد داده
- مناسب برای تشخیص نمونههای نادر
- عدم نیاز به تعریف دقیق نوع حمله
نمونه استفاده در Python:
from sklearn.ensemble import IsolationForest

model = IsolationForest(
    n_estimators=100,
    contamination=0.02,
    random_state=42
)

model.fit(training_data)

predictions = model.predict(new_data)
scores = model.decision_function(new_data)
در خروجی، معمولاً مقدار -1 بهعنوان ناهنجاری و مقدار 1 بهعنوان رفتار عادی در نظر گرفته میشود.
الگوریتم K-Means
K-Means دادهها را در چند گروه یا Cluster قرار میدهد. اگر یک نمونه فاصله زیادی از مرکز همه گروهها داشته باشد، ممکن است ناهنجار باشد.
این روش برای شناخت گروههای رفتاری مفید است. برای مثال، میتوان سیستمها را بر اساس رفتارشان به گروههای زیر تقسیم کرد:
- کاربران عادی
- سرورها
- تجهیزات شبکه
- سامانههای Backup
- سیستمهای مانیتورینگ
اما K-Means نیازمند انتخاب تعداد Clusterها است و برای همه محیطها بهتنهایی مناسب نیست.
الگوریتم One-Class SVM
این الگوریتم بیشتر برای یادگیری رفتار عادی استفاده میشود و سپس نمونههایی را که خارج از مرز رفتار عادی قرار دارند، شناسایی میکند.
One-Class SVM در دادههای با ابعاد محدود عملکرد مناسبی دارد، اما در شبکههای بزرگ و دادههای حجیم ممکن است نیازمند منابع پردازشی بیشتری باشد.
شبکههای عصبی Autoencoder
Autoencoder یک شبکه عصبی است که تلاش میکند ورودی خود را بازسازی کند. اگر مدل با رفتار عادی آموزش داده شود، دادههای عادی را با خطای کم بازسازی میکند. دادههای غیرعادی معمولاً خطای بازسازی بیشتری دارند.
این روش برای پروژههای پژوهشی و محیطهایی که داده کافی دارند، قابل بررسی است؛ اما پیچیدگی پیادهسازی و نیاز به تنظیمات بیشتر آن باید در نظر گرفته شود.
سناریوهای عملی تشخیص تهدیدات شبکه
بهکارگیری یادگیری ماشین در امنیت شبکه امکان شناسایی سناریوهای زیر را فراهم می کند:
مثال عینی اول: شناسایی اسکن پورت
فرض کنیم سیستم 10.10.20.45 متعلق به یکی از کاربران سازمان است. در حالت عادی:
Flow Count: 80 در هر ۵ دقیقه
Unique Destinations: 12
Unique Ports: 4
Outbound Bytes: 40 MB
اما در یک بازه زمانی، رفتار سیستم به این شکل تغییر میکند:
Flow Count: 2400
Unique Destinations: 210
Unique Ports: 95
Outbound Bytes: 18 MB
نکته جالب این است که حجم بایتها خیلی زیاد نیست، اما تعداد ارتباطها و پورتها افزایش شدیدی دارد. این الگو احتمالاً با انتقال فایل حجیم مرتبط نیست، بلکه میتواند نشاندهنده اسکن شبکه باشد.
مدل میتواند این نمونه را بهعنوان ناهنجاری شناسایی کند. سپس سامانه اطلاعات تکمیلی را بررسی میکند:
- آیا IP متعلق به اسکنر مجاز است؟
- آیا سیستم در اختیار تیم امنیت است؟
- آیا رخداد در زمان تست برنامهریزیشده رخ داده؟
- آیا مقصدها عمدتاً سرورهای داخلی هستند؟
اگر پاسخها نشان دهند فعالیت مجاز نیست، یک هشدار سطح بالا ایجاد میشود.
مثال عینی دوم: شناسایی انتقال غیرعادی اطلاعات
فرض کنیم یک لپتاپ کاربر در روزهای گذشته بهطور متوسط حجم زیر را ارسال کرده است:
- شنبه: 350 MB
- یکشنبه: 420 MB
- دوشنبه: 290 MB
- سهشنبه: 510 MB
- چهارشنبه: 380 MB
اما در روز پنجشنبه، این سیستم از ساعت ۲ بامداد تا ۴ بامداد، حدود ۱۲ گیگابایت داده به یک مقصد خارجی ارسال میکند.
ممکن است این رفتار ناشی از موارد زیر باشد:
- انتقال فایلهای کاری مجاز
- استفاده از سرویس Cloud
- اجرای Backup
- بدافزار
- سرقت اطلاعات
مدل یادگیری ماشین بهتنهایی نباید بلافاصله نتیجه بگیرد که این رخداد حمله است. اما میتواند به آن امتیاز ناهنجاری بالایی اختصاص دهد. سپس سامانه باید موارد زیر را بررسی کند:
- اعتبار مقصد
- نوع فایلها در صورت دسترسی به دادههای تکمیلی
- وضعیت کاربر
- سابقه فعالیت سیستم
- وجود رخدادهای امنیتی دیگر
- استفاده از VPN یا Proxy
اگر مقصد ناشناخته باشد و همزمان روی سیستم رویدادهای مشکوک دیگری نیز ثبت شده باشد، رخداد به تیم امنیت ارجاع داده میشود.
مثال عینی سوم: شناسایی ارتباط با سرور فرماندهی و کنترل
فرض کنیم یک سیستم داخلی در فواصل منظم، هر ۶۰ ثانیه ارتباطی کوتاه با یک IP خارجی برقرار میکند. حجم هر ارتباط کم است و در نگاه اول ممکن است مهم به نظر نرسد.
نمونه الگو:
Every 60 seconds:
Source: 10.10.40.25
Destination: 203.0.113.80
Destination Port: 443
Bytes: 2 KB
Duration: 2 seconds
این رفتار تکرارشونده میتواند با Beaconing بدافزار سازگار باشد. البته ارتباط منظم با یک سرویس خارجی همیشه مخرب نیست؛ سرویسهای قانونی نیز ممکن است بهصورت دورهای با سرورهای خود ارتباط برقرار کنند.
برای افزایش دقت، سامانه میتواند ویژگیهای زیر را بررسی کند:
- منظمبودن فاصله زمانی
- تازهبودن دامنه یا IP مقصد
- قرار داشتن مقصد در فهرست تهدید
- نوع سیستم مبدأ
- تعداد روزهای تداوم ارتباط
- رخدادهای Endpoint مربوط به همان سیستم
اگر چند شاخص همزمان مشکوک باشند، امتیاز ناهنجاری افزایش مییابد.
مثال عینی چهارم: تشخیص رفتار غیرمعمول یک سرور
رفتار سرورها معمولاً قابل پیشبینیتر از کاربران است. برای مثال، یک سرور مالی ممکن است فقط با پایگاه داده، سامانه احراز هویت و چند سرویس مشخص ارتباط داشته باشد.
اگر این سرور ناگهان با چندین سیستم ناشناخته در شبکه داخلی ارتباط برقرار کند، احتمال دارد:
- بدافزار روی آن اجرا شده باشد.
- حساب سرویس آن مورد سوءاستفاده قرار گرفته باشد.
- تنظیمات برنامه تغییر کرده باشد.
- مهاجم از آن برای حرکت جانبی استفاده کند.
در این شرایط، تعداد مقصدهای جدید، پورتهای جدید و زمان برقراری ارتباطها میتواند بهعنوان ویژگی وارد مدل شود.
مراحل پیادهسازی و ارزیابی عملکرد مدل
برای آموزش مدل، ابتدا باید دادهها جمعآوری و پاکسازی شوند. مراحل اصلی عبارتاند از:
- دریافت رکوردهای NetFlow
- حذف دادههای ناقص یا تکراری
- هماهنگسازی زمانها
- گروهبندی رکوردها در بازههای زمانی
- ساخت Featureها
- حذف یا بررسی فعالیتهای مجاز شناختهشده
- آموزش مدل
- آزمایش با دادههای جدید
- تنظیم آستانهها
- استقرار تدریجی
در روش بدون ناظر، لازم نیست برای تمام رکوردها برچسب حمله یا عادی داشته باشیم. مدل تلاش میکند ساختار کلی داده را یاد بگیرد.
بااینحال، استفاده از دادههای برچسبدار برای ارزیابی مدل اهمیت زیادی دارد. تیم امنیت میتواند بخشی از هشدارها را بررسی و آنها را بهعنوان موارد زیر علامتگذاری کند:
- True Positive
- False Positive
- True Negative
- False Negative
ارزیابی عملکرد سامانه: برای ارزیابی مدل، فقط تعداد هشدارها کافی نیست. معیارهای مختلفی باید بررسی شوند.
دقت یا Precision: نشان میدهد چه تعداد از هشدارهای ایجادشده واقعاً تهدید بودهاند.
اگر Precision پایین باشد، تعداد هشدارهای اشتباه زیاد است.
فراخوانی یا Recall: نشان میدهد چه تعداد از تهدیدهای واقعی شناسایی شدهاند. اگر Recall پایین باشد، سامانه بسیاری از حملات را از دست میدهد.
F1-Score: میانگین هماهنگ Precision و Recall است:
در سامانههای امنیتی، باید بین کاهش هشدارهای اشتباه و از دستندادن تهدیدها تعادل برقرار شود.
راهکارهای کاهش هشدارهای اشتباه (False Positives)
یادگیری ماشین نیز میتواند هشدار اشتباه تولید کند. برای کاهش این مشکل، من پیشنهاد میکنم مدل بهتنهایی تصمیم نهایی نگیرد و از اطلاعات تکمیلی استفاده شود.
راهکارهای مؤثر عبارتاند از:
- استفاده از Allowlist
- واردکردن نقش داراییها
- درنظرگرفتن ساعات کاری
- مقایسه با رفتار تاریخی همان سیستم
- ترکیب خروجی مدل با Syslog
- استفاده از Threat Intelligence
- تعریف سطحبندی هشدار
- بازبینی دورهای مدل
برای مثال، اگر الگوریتم یک سرور Backup را به دلیل ترافیک زیاد مشکوک تشخیص دهد، سیستم باید متوجه شود که این سرور در ساعات مشخصی عملیات پشتیبانگیری انجام میدهد.
چرخه بازخورد انسانی
هیچ سامانه تشخیص خودکاری نباید کاملاً بدون نظارت انسانی باقی بماند. کارشناسان امنیت باید بتوانند نتیجه هر هشدار را بررسی و درباره آن نظر دهند.
برای نمونه:
این اطلاعات میتواند در بهبود مدل استفاده شود. اگر تعداد زیادی هشدار مربوط به یک اسکنر مجاز باشد، سامانه باید آن تجهیز را بشناسد و امتیاز ناهنجاری آن را کاهش دهد. این چرخه باعث میشود مدل بهمرور با شرایط واقعی سازمان سازگارتر شود.
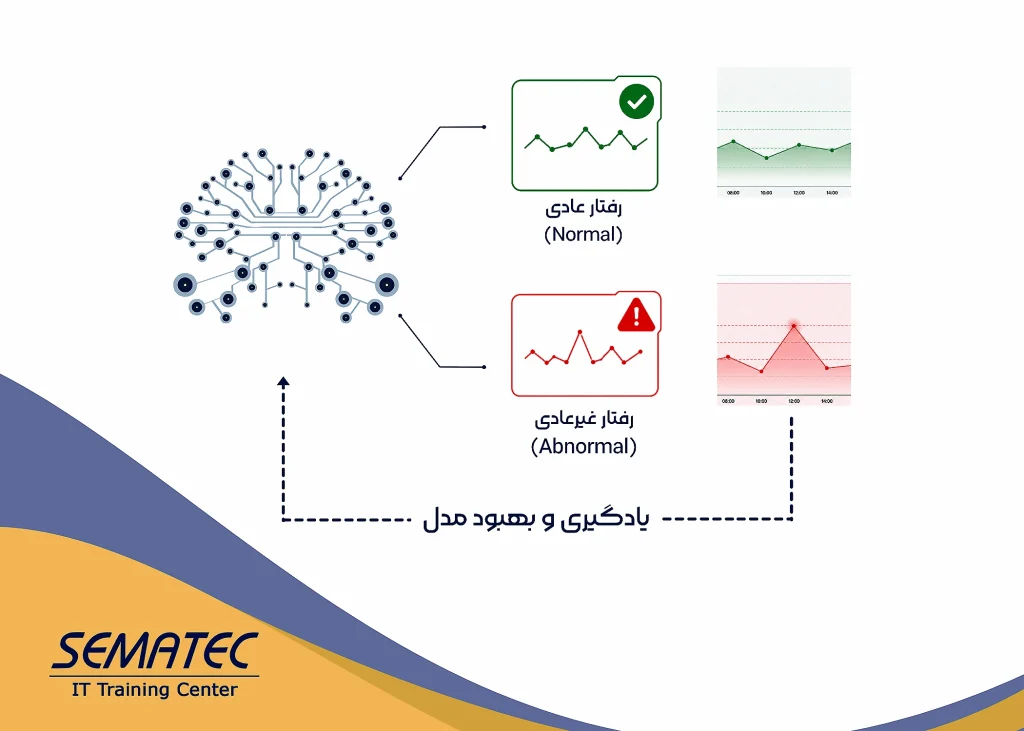
یادگیری و بهبود مدل یادگیری ماشین در امنیت شبکه
امنیت و محرمانگی دادهها
دادههای NetFlow ممکن است اطلاعات حساسی درباره ساختار شبکه، سرویسها، کاربران و مقصدهای ارتباطی ارائه کنند. بنابراین، نگهداری و پردازش آنها باید با ملاحظات امنیتی انجام شود.
اقدامات مهم عبارتاند از:
- محدودسازی دسترسی به Collector
- رمزنگاری ارتباطات مدیریتی
- تعیین دوره نگهداری داده
- حذف اطلاعات غیرضروری
- ثبت فعالیت کاربران سامانه
- جداسازی شبکه مدیریت
- رمزنگاری Backupها
- استفاده از حسابهای اختصاصی
- جلوگیری از نمایش عمومی اطلاعات IP داخلی
همچنین باید مشخص شود چه کسانی اجازه مشاهده داشبورد و گزارشهای ترافیکی را دارند.
چالشهای استفاده از یادگیری ماشین در امنیت شبکه
- کیفیت پایین داده: اگر NetFlow ناقص باشد یا بخشی از تجهیزات داده ارسال نکنند، مدل تصویر کاملی از شبکه نخواهد داشت.
- تغییر رفتار شبکه: با اضافهشدن سرویس جدید یا تغییر معماری، مدل قدیمی ممکن است هشدارهای اشتباه تولید کند.
- حملات فرار از تشخیص: مهاجمان ممکن است رفتار خود را شبیه ترافیک عادی کنند تا از مدل عبور کنند.
- تفسیرپذیری: برخی مدلها فقط میگویند یک نمونه غیرعادی است، اما دلیل دقیق آن را بهسادگی توضیح نمیدهند. برای تیم امنیت، دانستن دلیل هشدار بسیار مهم است.
- نیاز به منابع پردازشی: در شبکههای بزرگ، تحلیل حجم بالای Flow نیازمند پردازش، ذخیرهسازی و معماری مقیاسپذیر است.
مراحل پیادهسازی و ارزیابی عملکرد مدل
من اجرای این پروژه را در چند مرحله پیشنهاد میکنم:
- مرحله اول: ایجاد خط پایه: در این مرحله، دادههای شبکه بدون واکنش خودکار جمعآوری میشوند و رفتار عادی داراییها مشخص میشود.
- مرحله دوم: توسعه تحلیلهای آماری: شاخصهایی مانند میانگین ترافیک، تعداد مقصدها و تعداد پورتها محاسبه میشوند.
- مرحله سوم: استفاده از الگوریتمهای ساده: الگوریتمهایی مانند Isolation Forest یا One-Class SVM روی دادهها آزمایش میشوند.
- مرحله چهارم: اعتبارسنجی با کارشناسان: تیم امنیت هشدارها را بررسی و موارد صحیح و اشتباه را ثبت میکند.
- مرحله پنجم: اتصال به SIEM: خروجی مدل به سامانه مرکزی مدیریت رخداد ارسال میشود.
- مرحله ششم: پاسخ نیمهخودکار: سامانه پیشنهاد اقدام ارائه میدهد، اما اجرای آن نیازمند تأیید کارشناس است.
- مرحله هفتم: پاسخ خودکار محدود: در سناریوهای با قطعیت بالا، مانند ارتباط با IP کاملاً مخرب، میتوان محدودسازی موقت را فعال کرد.
جمعبندی
از دیدگاه من، استفاده از یادگیری ماشین برای تشخیص رفتارهای غیرعادی در ترافیک شبکه، یکی از مسیرهای مهم آینده امنیت زیرساخت است. شبکههای امروزی آنقدر پیچیده و پرحجم شدهاند که بررسی همه رخدادها با روش دستی یا تنها با چند قانون ثابت، دشوار و گاهی غیرممکن است.
با استفاده از دادههایی مانند NetFlow، IPFIX، Syslog و اطلاعات داراییها میتوان تصویری دقیقتر از رفتار شبکه ایجاد کرد. سپس الگوریتمهایی مانند Isolation Forest، K-Means، One-Class SVM و Autoencoder میتوانند به شناسایی نمونههایی کمک کنند که از الگوی عادی فاصله دارند.
مثالهایی مانند تشخیص اسکن پورت، انتقال غیرعادی اطلاعات، ارتباط دورهای با سرور فرماندهی و کنترل، حملات احتمالی DDoS و تغییر رفتار یک سرور حساس نشان میدهند که یادگیری ماشین میتواند نقش مهمی در کاهش زمان شناسایی تهدید ایفا کند.
بااینحال، یادگیری ماشین جایگزین کامل کارشناسان امنیت نیست. مدل باید در کنار قواعد امنیتی، Threat Intelligence، اطلاعات داراییها و تحلیل انسانی مورد استفاده قرار گیرد. همچنین کیفیت داده، بهروزرسانی مدل، کنترل هشدارهای اشتباه و تفسیرپذیری نتایج باید از ابتدای پروژه در نظر گرفته شوند.
به نظر من، بهترین روش برای شروع، اجرای یک پروژه محدود و قابلاندازهگیری است. سازمان میتواند ابتدا فقط روی تشخیص اسکن پورت و رفتار غیرعادی خروجی تمرکز کند، سپس پس از بررسی نتایج، ویژگیها و الگوریتمهای بیشتری اضافه نماید.
در نهایت، هدف از بهکارگیری یادگیری ماشین در شبکه، ایجاد یک سیستم پیچیده و غیرقابلفهم نیست؛ بلکه هدف، ساخت ابزاری است که بتواند در میان حجم زیاد داده، نشانههای مهم را پیدا کند و آنها را به شکلی قابلاستفاده در اختیار تیمهای شبکه و امنیت قرار دهد. من معتقدم ترکیب Python، NetFlow، یادگیری ماشین و تجربه کارشناسان میتواند سازمانها را در مسیر ایجاد شبکهای هوشمندتر، پایدارتر و امنتر یاری کند.